
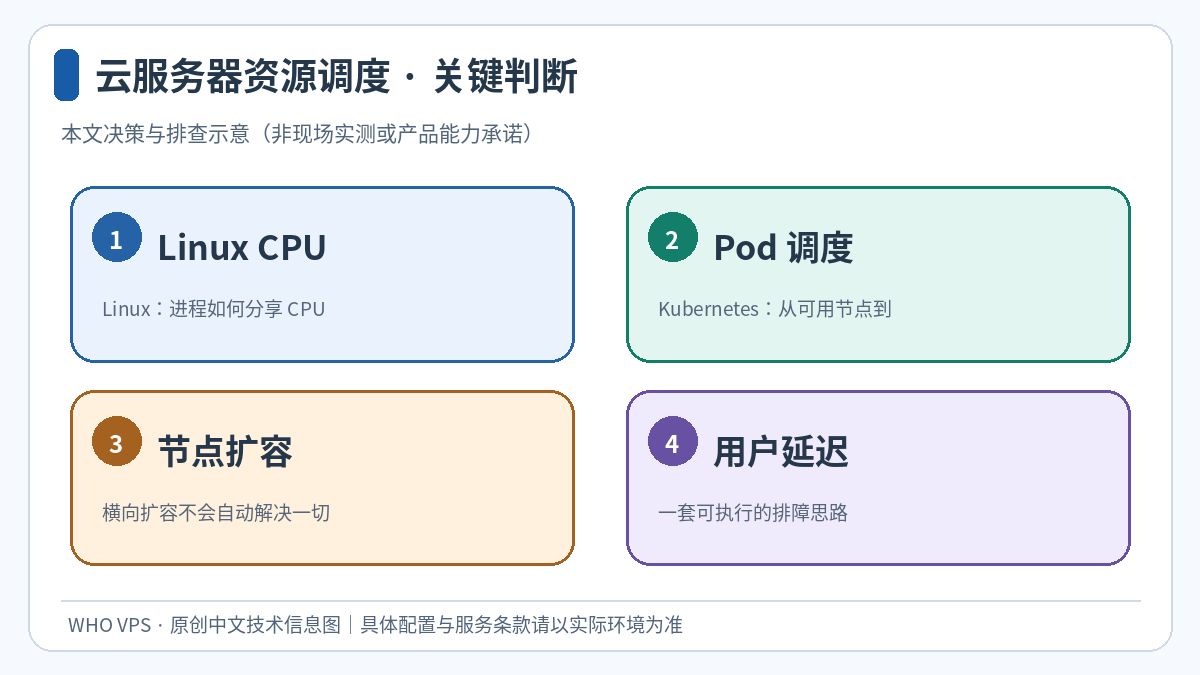
“调度”至少包含三个不同层次:Linux 内核决定进程何时占用 CPU;Kubernetes 决定 Pod 去哪个节点;云平台决定如何提供容量与弹性扩缩容。混用这些概念,会造成调了应用副本数却没有解决 CPU 竞争的情况。
Linux:进程如何分享 CPU
Linux 官方文档描述了从 CFS 向 EEVDF 的演进。EEVDF 使用虚拟运行时间与虚拟截止时间选取可运行任务,有利于在公平性与响应性之间安排执行。实际表现还取决于内核版本、优先级、CPU 配额和任务行为;对延迟敏感服务,先检查是否被 cgroup 限额节流,而不是未经测量调整复杂内核参数。
Kubernetes:从可用节点到最合适节点
kube-scheduler 先筛选满足约束的节点,再给候选节点评分,最终绑定 Pod。CPU/内存 requests 参与调度,limits 影响运行时资源使用,两者作用不同。Pod 一直 Pending 时,应先查看事件和资源请求,检查污点/容忍、节点亲和、持久卷拓扑与扩容能力,而非直接增加 replicas。
横向扩容不会自动解决一切
HPA 可以按资源或自定义指标增加 Pod 数量,但如果数据库或共享存储才是瓶颈,复制应用层可能进一步放大压力。节点扩容也需要时间,冷启动、镜像拉取和就绪探针都会影响实际接单速度。对重要业务,要把伸缩触发阈值与队列积压、请求延迟和错误率一起观察。
一套可执行的排障思路
从用户体验指标入手,依次核对应用日志、Pod 状态、CPU throttling、节点负载和数据库延迟。每次只改变一个主要变量,并记录流量、资源请求、版本及回滚方法。不要把未经复现的“利用率提升 65%”当作调度算法固有效果。
上线前的核对清单
- 区分内核、容器和云平台调度层次
- 先检查 Pod Pending 事件和 requests
- 对延迟尖峰同时检查 CPU 限额与后端依赖
- 用相同负载记录前后结果和回滚点
如果还需要延伸排查,可参考站内的相关部署指南。
技术资料
关键概念以Linux EEVDF 的调度机制、Kubernetes 节点筛选与打分流程为依据;实际版本、价格与机房参数请另行核对。


