
企业网络性能治理应先建立可重复测量的基线,再定位网络、应用、主机哪个环节拖慢服务。某个新协议、BGP 路由或更高带宽不能保证端到端业务没有故障。
把端到端路径拆开
一次 Web 请求通常经过 DNS、TCP/TLS 建连、边缘代理、后端应用与数据库。记录各阶段耗时才能判断应优化缓存、线路还是数据库;不要用平均 ping 代替 p95 业务响应时间。对跨境分支机构还需按不同时段测丢包与抖动。
选择优化措施要针对瓶颈
若静态资源回源过多,可以调整 CDN 缓存与过期规则;若数据库锁竞争严重,应优化查询和事务;若长连接经常断开,应检查负载均衡空闲超时、NAT 会话与应用心跳。某些 TCP 拥塞控制算法只在特定网络环境下有效,应通过受控 A/B 测试评估。
容错优先于追求单次峰值
针对重要 API 设置合理超时、重试预算和熔断,避免故障放大。网络变更要保存配置快照、影响范围和恢复指令;多区域接入还需验证身份会话与数据一致性,不是简单在 DNS 中增加多个 IP。
实施前需要记录的三类证据
| 检查维度 | 应记录的内容 | 操作与验收方法 |
|---|---|---|
| 路径观测 | 分段 RTT、丢包、抖动和跳数 | 多地区多时段持续观测 |
| 吞吐性能 | 长连接、拥塞控制和接口负载 | 控制变量进行并发测试 |
| 可用性 | BGP 线路说明、故障隔离与冗余 | 向服务商核对跨线路故障方案 |
测量请求全路径到容错与回滚验证:工作流程图
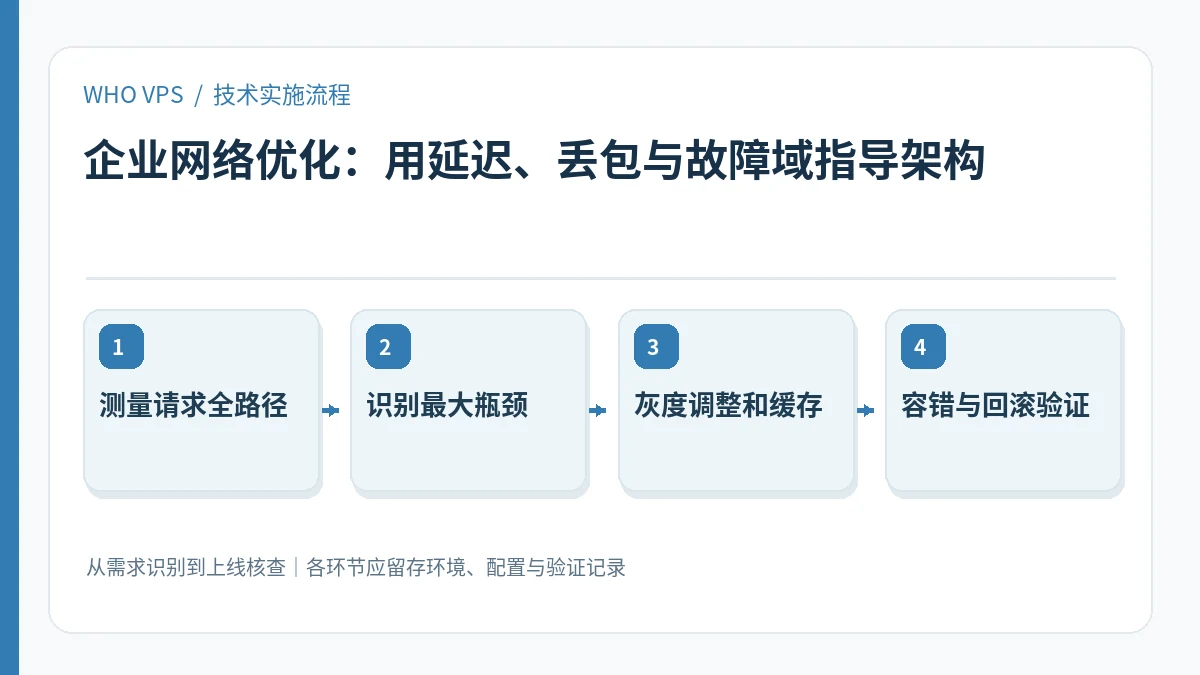
以下流程是落地执行顺序,建议为每一步保留配置快照、操作人和校验结果;在生产环境修改之前先准备恢复路径。
- 测量请求全路径:明确当前环境与业务目标,列出系统版本、权限、地域和预期负载。
- 识别最大瓶颈:根据上一阶段信息选择可回退的配置,避免同时修改多个相互影响的变量。
- 灰度调整和缓存:以受控测试或对照环境验证配置,遇到异常优先查看日志和监控。
- 容错与回滚验证:记录结果和剩余限制,把复测触发条件纳入日常巡检。
怎样判断方案有效,以及不适用的情况
验收依据:同业务流量比较各阶段 p50/p95/p99、丢包、重试量、5xx、连接建立时间和故障恢复时间。
使用限制:没有可核查的测试过程,不应引用“全球延迟低于某毫秒”或“网络损失某亿美元”等数字。
如果观察结果不稳定,先保持业务场景、测试位置与时间段可比,再判断是资源瓶颈、服务边界还是配置错误。缺少可复现的数据时,不应把单次结果外推成稳定收益。
官方资料与进一步阅读
- NGINX:反向代理和 upstream 配置:以产品/项目的现行官方说明为配置与版本核查依据。
- Cloudflare:DNS 设置、记录和解析概念:以产品/项目的现行官方说明为配置与版本核查依据。


