
Triton 真正负责什么
NVIDIA Triton Inference Server 为多种模型后端提供统一推理服务接口,并围绕模型仓库、调度器、后端实例与可观测性组织推理请求。是否需要 GPU、哪种后端可用,应依据具体模型和服务器版本确认,而不是假设“所有模型必须用 A100”。部署生产前先核对发行版本和支持矩阵。
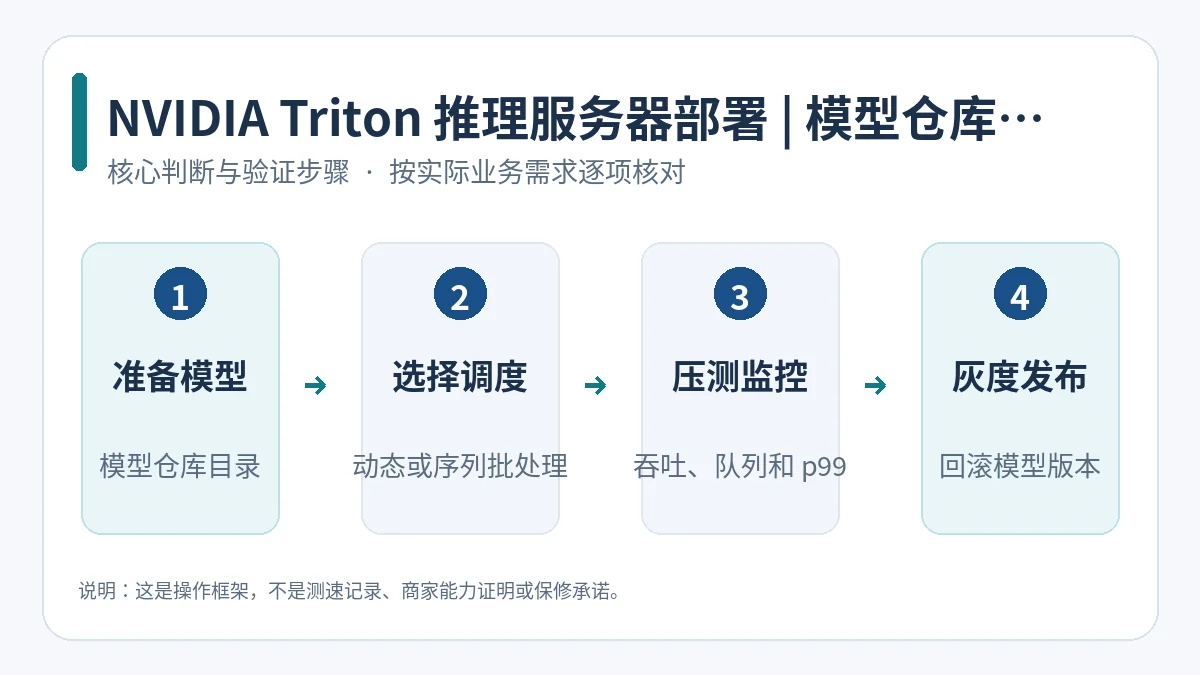
从模型仓库开始
官方模型仓库采用“模型名称 / 版本目录 / 模型文件”组织,并可按需要通过 config.pbtxt 指定输入输出、实例组和批处理参数。对输入形状与类型没有明确约定的模型不能直接靠服务端自动推断一切。建议先使用一个已知可用模型校验 HTTP/gRPC 推理结果及模型版本管理。
动态批处理的正确边界
Triton 的 Dynamic Batcher 主要适用于无状态且可合并请求的模型。增大批量可能改善吞吐,但也可能增加排队时间,尤其是低并发场景。序列相关任务有独立调度机制;不能把 Dynamic Batching 一概称作大模型的 Continuous Batching,也不能不经测试承诺 GPU 利用率或延迟提升百分比。
观测与压测
使用 Triton 官方性能分析工具,在代表性输入和并发下观察 p95/p99、吞吐、队列等待与内存占用。官方指标接口通常在 8002/metrics,仅应在可信网络中暴露,避免直接向互联网开放管理和指标端点。把模型加载失败、GPU 内存不足与服务网络错误分别告警。
发布与回退
固定镜像、模型版本及输入协议,在预发布环境对比同一测试集的输出与性能。先灰度部分流量,再切换版本;若出现准确性或延迟退化,应能快速恢复上一模型。
📈 数据翔实