
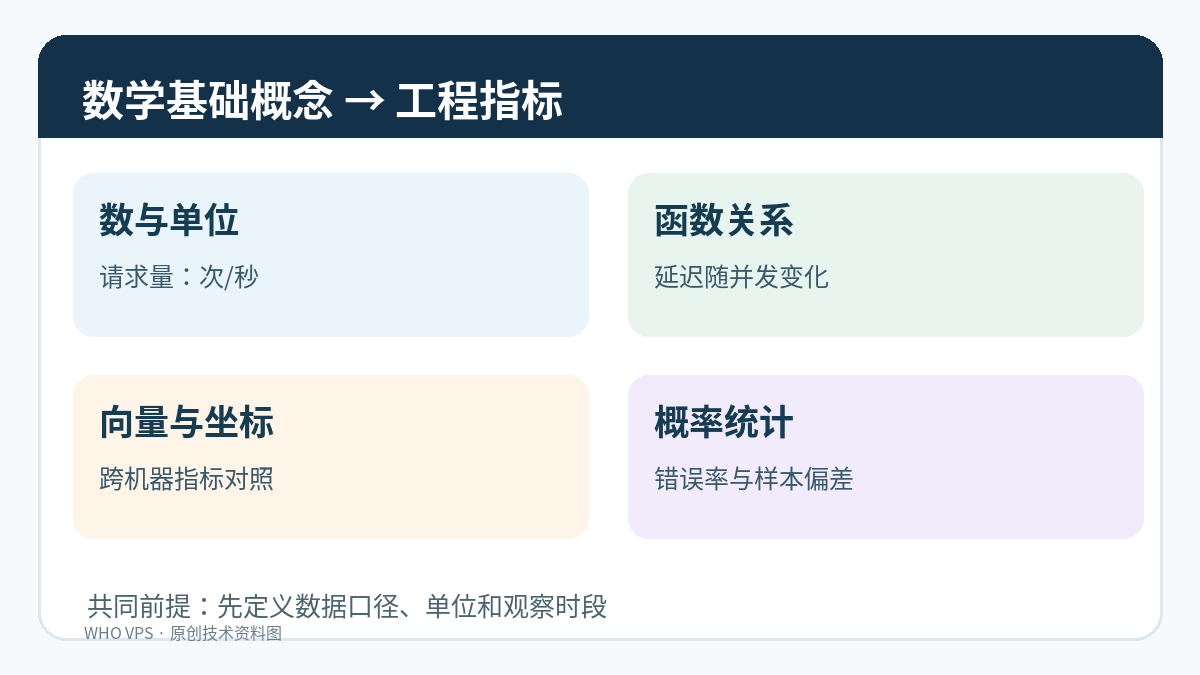
理解数学基础,不必一开始就背完复杂的公理。把“数与单位、函数关系、几何结构、概率统计”四块弄明白,已经足以读懂很多工程和数据分析问题。以服务器运维为例:请求数是计数,吞吐量是单位时间里的数量,延迟可看成随时间变化的函数,故障率则需要统计窗口。
数集与单位:先问“这个数代表什么”
自然数适合计数,例如队列中有多少任务;整数允许负数,可以表示余额变化;有理数表示可写成两个整数之比的数;实数支持通常的连续量建模。数据系统还经常使用布尔值来表示开关状态。真正做计算时,必须连同单位记录数值:每秒 120 次请求与每分钟 120 次请求不是同一个量。
容量规划的第一步可从单位换算做起。比如稳定到达率为每秒 25 个请求,持续 60 秒,则该时段共有 1,500 个请求。这个算式并不告诉我们响应时间、带宽消耗或需要多少 CPU;要评估这些,需要再引入每个请求的平均资源需求和峰值变化。
函数:用输入与输出刻画关系
函数的核心是:在给定定义域里,每个允许的输入对应唯一的输出。比如用 f(t) 表示时刻 t 的并发连接数,或用 L(n) 表示给定并发数 n 时的一次请求响应时间。函数不保证总是线性;缓存失效、排队或资源饱和可能造成突然升高。画图时写清横轴、纵轴、采样窗口和单位,才能避免读者把两条完全不同的曲线拿来比较。
增长率是函数思想的自然延伸:若 t=1 分钟和 t=2 分钟时队列分别为 200、260,则这段时间队列净增加 60 条/分钟。它只是区间平均值,不代表每一秒都如此。更深入的变化率、极限与微积分,可在掌握函数后逐步学习。
几何与线性代数:从位置到向量
几何研究长度、角度、坐标与空间关系。二维坐标可以表达监控散点图:横轴 CPU 利用率、纵轴请求延迟,每个点代表一次测量。线性代数则把一组数写成向量或矩阵,用来表示多台服务器的 CPU、内存、磁盘等指标。它能帮助批量处理数据,但矩阵计算本身不会让网络自动变快。
例如一组机器的 CPU 使用率向量为 (35%, 70%, 90%),你可以一眼看到第三台更接近繁忙状态;但是否扩容,还需要结合 CPU 型号、持续时间、等待队列和应用错误率。不要仅凭一个百分比下结论。
概率与统计:把“偶然”同“常态”分开
概率描述随机事件发生的可能性;统计则试图用观察到的样本理解总体。假设 1,000 次请求里失败 8 次,观察到的失败比例是 0.8%。这不是未来失败概率已被精确证明;样本时段、用户位置、错误口径和是否覆盖高峰都可能影响结果。
比较优化前后时,尽量使用相同采样方法,并一起看请求数、平均延迟、分位数延迟和错误率。平均值可能掩盖尾部慢请求:如果大多数请求都快,少数请求特别慢,单看平均响应时间容易误判体验。统计结论需要把不确定性和样本代表性说清楚。
把数学用到一次实际排障中
- 先设问题:网站在访问高峰是否响应变慢,而不是预先认定是 CPU 不够。
- 定义指标和单位:每分钟请求数、5xx 错误率、p95 响应时间、CPU 利用率。
- 画同时间轴的趋势图,区分相关性与因果关系;响应变慢也可能来自数据库、磁盘或第三方接口。
- 针对一个疑点做可回滚的变化,并在类似流量条件下重复测量。
- 汇报结果时写样本时段、数据范围与局限,不以一次峰值证明整个系统稳定。
常见误区与进一步阅读
“数学公式越复杂,方案越好”并不成立。工程上首先需要定义准确、数据可靠、模型能检验。学习函数、概率与统计可参考OpenStax 的函数章节和概率统计基础解释;若想用 Python 实现数据处理,也可延伸阅读站内 NumPy 数值计算指南。


