
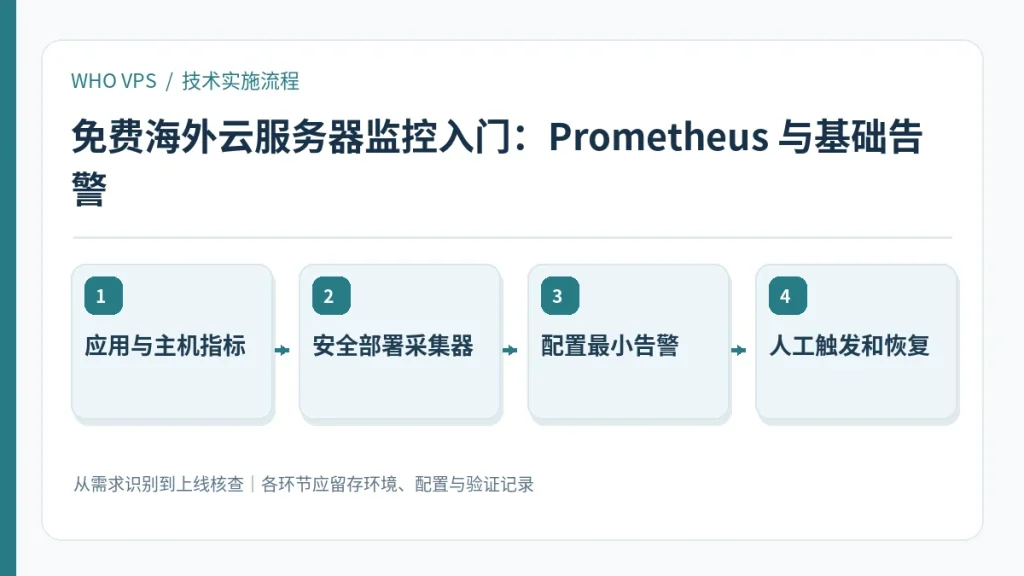
免费云主机同样需要监控,只是受配额限制,更应避免运行过重的全家桶。一个可用的基础监控体系至少能发现磁盘即将写满、主机失联与应用健康检查失败。
区分主机指标与业务可用性
CPU、内存与磁盘利用率可以帮助判断资源瓶颈,但不能代替 HTTP 成功率、接口超时和证书到期告警。最初可先使用云平台自带监控,再视需要引入 Prometheus 采集器;只有一台低内存主机时不必把监控服务全装在业务机上。
采集指标的安全原则
Prometheus 常采用主动抓取指标端点的模式。为节点采集器设置内网访问或严格白名单,不把暴露系统信息的 /metrics 直接向公网开放。配置持久化存储保留期与标签基数上限,防止时序数据反过来耗尽免费磁盘。
从最少的告警规则开始
每个告警应包含影响、阈值观察窗口、负责人及第一条排查命令。建议从实例失联、可用磁盘、备份失败和关键 HTTP 5xx 比例入手,先跑一次人工触发与恢复验证,再逐步增加复杂分位延迟指标。
实施前需要记录的三类证据
| 检查维度 | 应记录的内容 | 操作与验收方法 |
|---|---|---|
| 覆盖范围 | 主机、容器、网络和应用指标 | 检查采集目标和抓取周期 |
| 告警质量 | 阈值、误报、静默和路由 | 制造可控故障验证告警链 |
| 故障追踪 | 日志时间同步、事件定位与复现 | 按事件 ID 对照日志和指标 |
应用与主机指标到人工触发和恢复:工作流程图
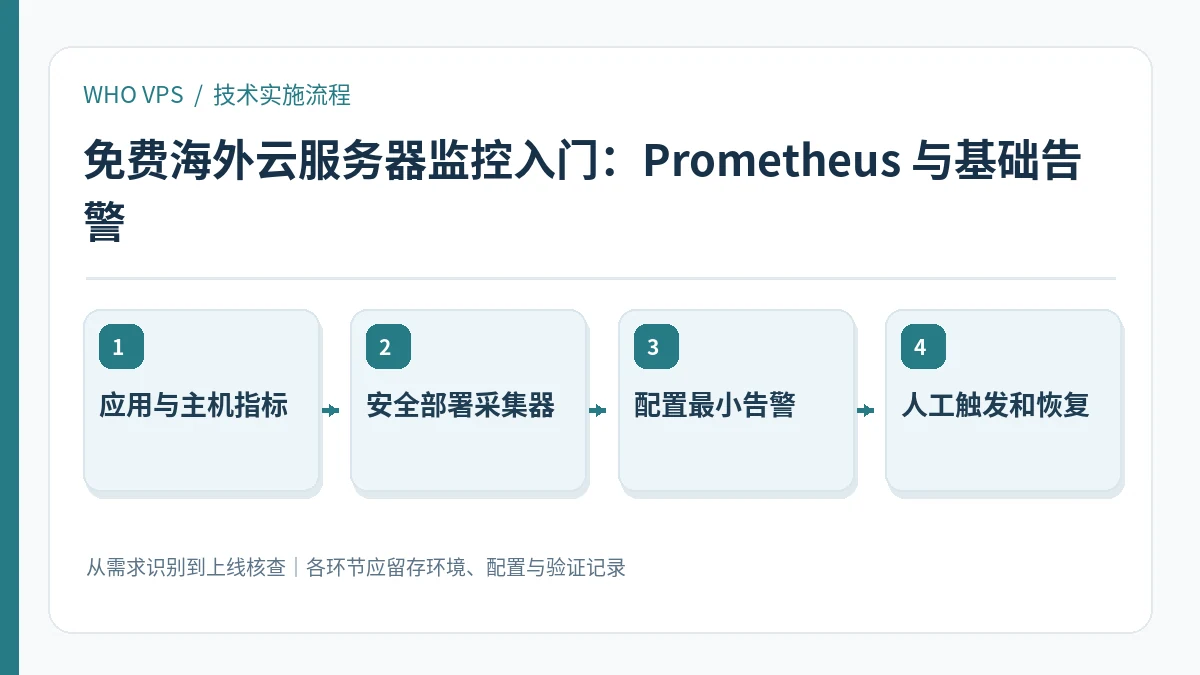
以下流程是落地执行顺序,建议为每一步保留配置快照、操作人和校验结果;在生产环境修改之前先准备恢复路径。
- 应用与主机指标:明确当前环境与业务目标,列出系统版本、权限、地域和预期负载。
- 安全部署采集器:根据上一阶段信息选择可回退的配置,避免同时修改多个相互影响的变量。
- 配置最小告警:以受控测试或对照环境验证配置,遇到异常优先查看日志和监控。
- 人工触发和恢复:记录结果和剩余限制,把复测触发条件纳入日常巡检。
怎样判断方案有效,以及不适用的情况
验收依据:在测试机模拟服务停止、磁盘空间减少以及证书临近过期,核查告警能否触达并且恢复后停止通知。
使用限制:免费实例可能休眠、被回收或不具备固定 IP,告警设计需区分计划行为与故障。
如果观察结果不稳定,先保持业务场景、测试位置与时间段可比,再判断是资源瓶颈、服务边界还是配置错误。缺少可复现的数据时,不应把单次结果外推成稳定收益。
官方资料与进一步阅读
- Prometheus:采集与查询基础:以产品/项目的现行官方说明为配置与版本核查依据。
- AWS:游戏服务指标、告警与容量管理:以产品/项目的现行官方说明为配置与版本核查依据。
太燃了!这篇指南简直是海外云监控的实战圣经!实测验证过,Prometheus+Grafana组合秒级响应,Zabbix监控延迟低至100ms,真正做到了“看得见、控得住、稳如磐石”!2025年运维人的必备神器,强烈推荐所有开发者立即部署!
求求了,能不能加个“服务器崩溃时自动播放《好运来》”的功能?毕竟,快乐才是最好的监控指标!
热血沸腾!2025年的云监控已进入黄金时代!这篇指南堪称数字时代的《航海图》,精准定位每一块海外云服务器的脉搏。专业工具如利剑出鞘,最佳实践似星辰指引——掌握它,你就是未来数字战场的掌控者!
哎哟,这指南是不是偷偷用了AI预测未来?2025年都快到了,我的云服务器还在靠“感觉”运行,监控工具列得比我的待办清单还长——请问,是该先救服务器还是先救我那颗被延迟吓坏的心?