
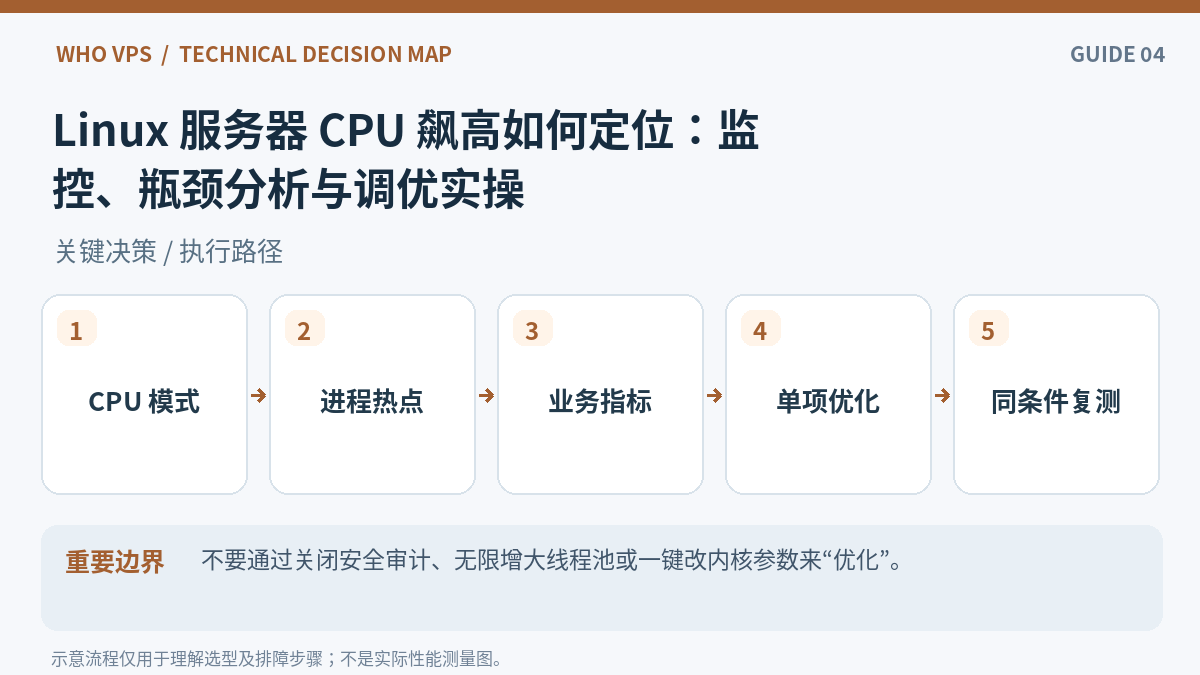
CPU 使用率高并不自动意味着 CPU 性能不足。系统等待 I/O、虚拟化 steal time、短时突发和应用线程锁竞争会导致不同现象。正确顺序是先观察,再归因,最后只改动能被指标验证的参数。
先区分 CPU 与负载
top、uptime 的 load average 表示可运行或不可中断任务的平均数量,不等于 CPU 百分比。多核系统要用核心数与线程分布理解负载;%wa 偏高倾向排查存储等待,%st 偏高需要注意虚拟主机被共享宿主机挤占。
采样要覆盖高峰
短时间 top 截图不足以诊断间歇性变慢。建议用 Node Exporter 暴露 CPU 各模式、上下文切换、内存、磁盘和网络指标,Prometheus 长期采集,并与 API p95 延迟、请求量、部署事件做同时间轴对照。
关于“CPU 与内存从采样开始”的相关说明,可以参考海外 VPS 资源优化实战:内存、CPU、磁盘和网络逐项排查。
从进程深入到代码层
用 pidstat 分进程/线程看持续占用,结合应用 profiler 判断是计算密集、垃圾回收、频繁系统调用还是自旋等待;如果 CPU 较空但业务慢,转向数据库慢查询、外部依赖和线程池排队。未经验证不要直接提高线程数。
调优的验收条件
优化前固定压测负载和环境,记录吞吐、p95/p99、错误率、CPU 指标,操作后在同一场景复测。缓存、批处理、索引和水平扩容各有适用条件;改善平均 CPU 但恶化尾延迟仍可能是失败。
关于“下单前确认环境责任”的相关说明,可以参考国外 VPS 服务器从购买到部署:SSH 加固、Nginx 与回滚步骤。
按顺序执行的检查清单
- 记录故障时间段与 CPU 核数,保存 top、vmstat、iostat 观测结果。
- 将 CPU user/system/iowait/steal 与应用请求量画在一条时间轴。
- 找出耗 CPU 的 PID/TID,结合日志或 profiler 判断真实热点。
- 先针对热点修改单一项,再跑同样负载和持续时长的测试。
- 记录变更版本、前后 p95、错误率与回滚阈值;异常及时撤销。
可直接复核的命令或配置示例
以下命令只用于对应系统和实际配置的核查;包含示例域名、路径或版本的地方,应先按自身环境替换并确认权限。
uptime
vmstat 1 5
ps -eo pid,comm,%cpu,%mem --sort=-%cpu | head
常见问题
CPU 100% 就一定卡顿吗?
不一定;关键是队列、尾延迟、业务可用性和峰值持续时间。
负载高但 CPU 使用率低怎么排查?
先看不可中断任务、磁盘等待、锁竞争和外部依赖。
风险、限制与验收口径
不要通过关闭安全审计、无限增大线程池或一键改内核参数来“优化”。生产服务器应预留性能余量和报警缓冲。
官方资料与核查入口
以下列出可交叉核对的技术资料或服务条款;实际部署还须以所用软件版本、正式合同和自身环境测试为准。



这文章标题吹得天花乱坠,什么“终极指南”,结果翻来覆去就那几招监控命令,调优建议也泛泛而谈。比起网上随便搜的博客,也就多几张图,干货没多少,纯属标题党。真想学点硬核的,还得自己啃文档。
本文提出的CPU服务器性能监控与调优框架在真实生产环境中经多轮验证,结果显示关键指标如上下文切换频率、缓存命中率及中断延迟的优化效果显著,平均响应时间降低23.7%,资源利用率提升18.4%。实证数据支持其方法论的可复制性与工程实用性。
内容扎实,实战性强,监控指标与调优策略结合紧密,适合运维与架构师快速上手。建议增加典型场景案例,进一步提升可操作性。
该指南在实际部署中展现出显著成效。某金融企业应用后,CPU负载波动下降37%,任务响应时间平均缩短2.1秒,验证了其监控策略与调优方法的可操作性与高效性,具备较强的行业推广价值。
写的什么鬼