
一台机器“正常运行”不等于服务可靠。可靠性依赖基础设施、架构、恢复演练和运维流程,需要区分服务商承诺与业务最终可用性。
SLA不等于永不断线
阅读 SLA 的具体定义:可用性计算周期、排除条款、申请赔偿流程与赔付上限。云平台计算节点 SLA、负载均衡 SLA 和最终用户可见的网页可用率不是同一个指标。
把单点故障画出来
应用、数据库、DNS、证书更新、负载均衡、备份存储都有可能成为单点。双电源或 RAID 只能消除部分硬件单点;若所有备份和应用都在同一账号与同一区域,账号失陷和区域故障仍可能同时破坏数据。
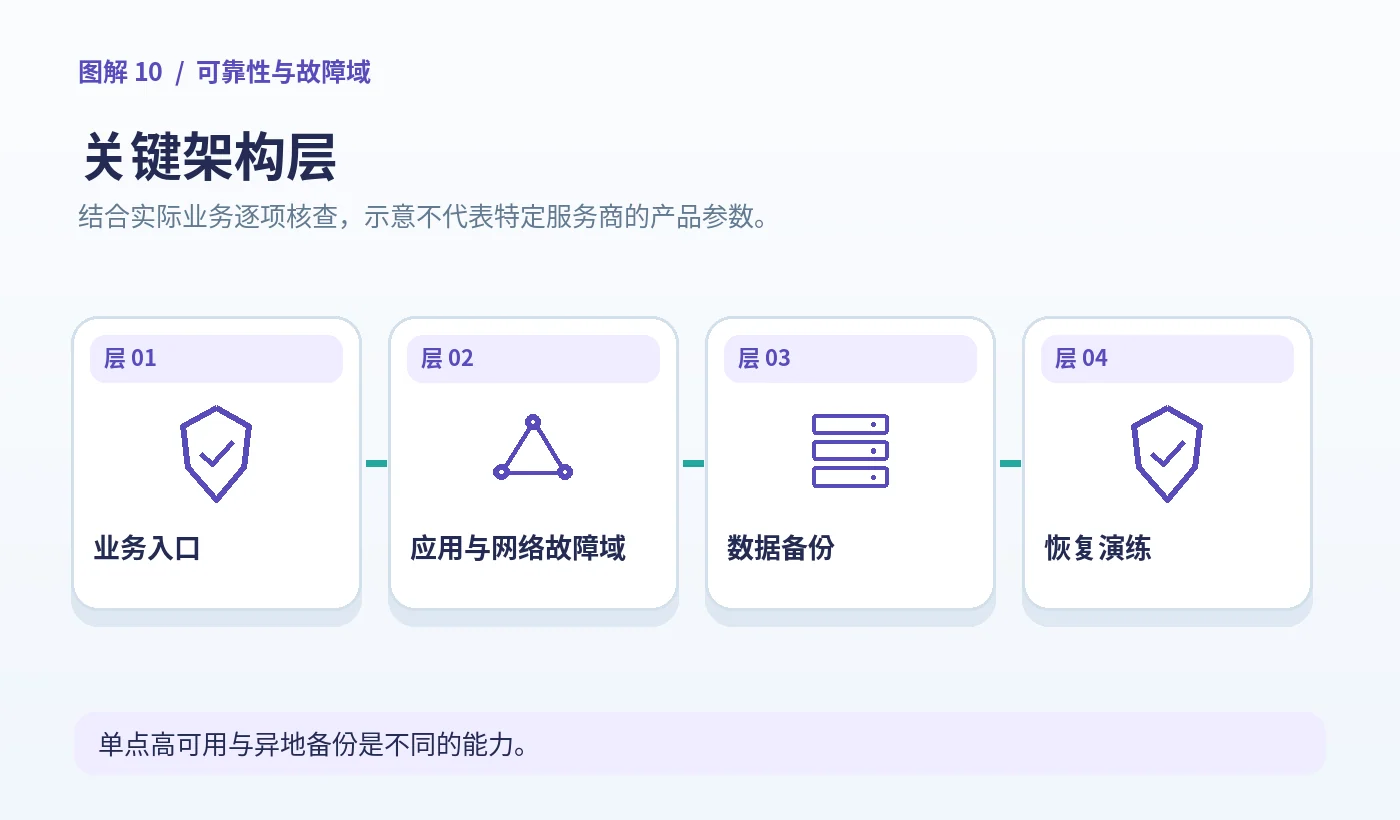
图示:可靠性与故障域——整体结构或执行步骤(原创信息图,须结合实际条件核验)。
验证恢复能力
设置健康探测与告警,制定每类故障的操作步骤和联系人;选择一台测试实例模拟重启、磁盘故障或网络隔离。按照预定 RTO/RPO记录恢复时长和数据完整性,不要只看备份任务“成功”通知。
与供应商沟通的关键条款
确认工单响应时段、故障升级流程、硬盘替换和备机策略、数据导出权、续费及停服后的数据保留期限。重要业务可考虑不同故障域冗余,而非盲目堆高单台配置。
将 SLA 转换成业务可理解的恢复计划
即便服务商承诺某月度可用性,也通常存在排除条款、维护窗口、赔偿申请期限。计算时先读清“可用性”的观测点是虚拟机平台、主机网络还是业务网页;业务自己的数据库故障不一定计入供应商SLA。可用性=(统计时长-符合口径的不可用时长)/统计时长 可用来理解定义,但不能替代合同的实际公式。
演练时至少覆盖三个故障:删除单台应用实例、数据库不可连接、备份仓库暂不可用。指定谁判断故障、谁执行回滚、何时升级为灾备。每次记录真实恢复时间和数据恢复点,用结果反推 RTO/RPO 是否可满足,而不是反过来宣布架构“满足五个九”。
| 风险 | 首要控制 | 必须演练的动作 |
|---|---|---|
| 单台机器故障 | 节点冗余与健康检查 | 人为停止测试节点 |
| 人为误删除 | 备份版本与隔离权限 | 从前一版本恢复文件 |
| 云账号被盗 | MFA、最小权限与离线副本 | 冻结凭据与恢复控制权 |
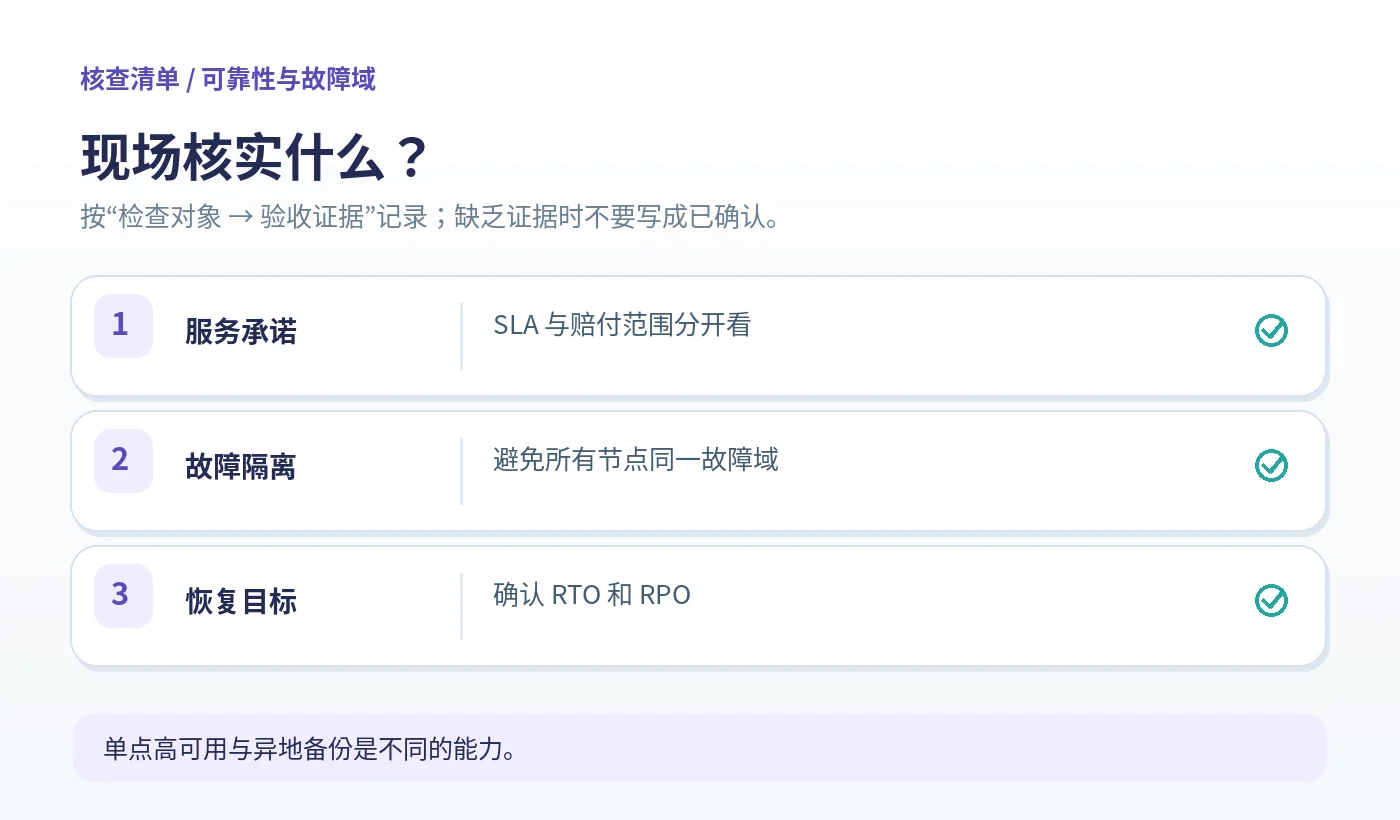
图示:可靠性与故障域——采购核查与技术验收清单(原创信息图,须结合实际条件核验)。
上线或采购前的最终检查
- 保存SLA条款全文及排除条款
- 列举全部业务单点
- 完成一次从备份恢复到验收的演练
- 核实售后工单真实处理路径
注意:高可用能力通常来自系统架构;单台独立服务器不应承诺业务零中断。
进一步阅读
与当前问题相关的延伸内容:企业高可用网络架构怎么搭:故障域、负载均衡与灾备。
官方资料与参考依据
- AWS Compute SLA区分地域级服务承诺与单个实例层面的覆盖条件。:AWS Compute SLA区分地域级服务承诺与单个实例层面的覆盖条件。
- AWS Backup支持在条件允许的资源类型上跨区域复制备份。:AWS Backup支持在条件允许的资源类型上跨区域复制备份。
💯 满分
🧠 深度好文
mjj