
租 GPU 主机前要先知道模型需要多少显存、使用何种驱动和框架、任务运行多久。只按GPU型号或显存数字选择,容易买到不适合的实例。
任务先分类
推理主要关注模型量化精度、批次大小、上下文长度与吞吐目标;训练还涉及优化器状态、梯度缓存、显存峰值以及多卡通信。渲染和视频转码关注相关编解码支持与许可证限制。一个任务可运行不代表能达到所需响应时延。
核查机器与软件兼容
查看 GPU 显存容量、是否为共享/vGPU、PCIe 或 NVLink连接、CPU/内存比例、磁盘读写及网络。确认驱动版本、CUDA/ROCm 环境与容器映像可用;不要仅凭厂商宣传的浮点峰值替代模型实测。
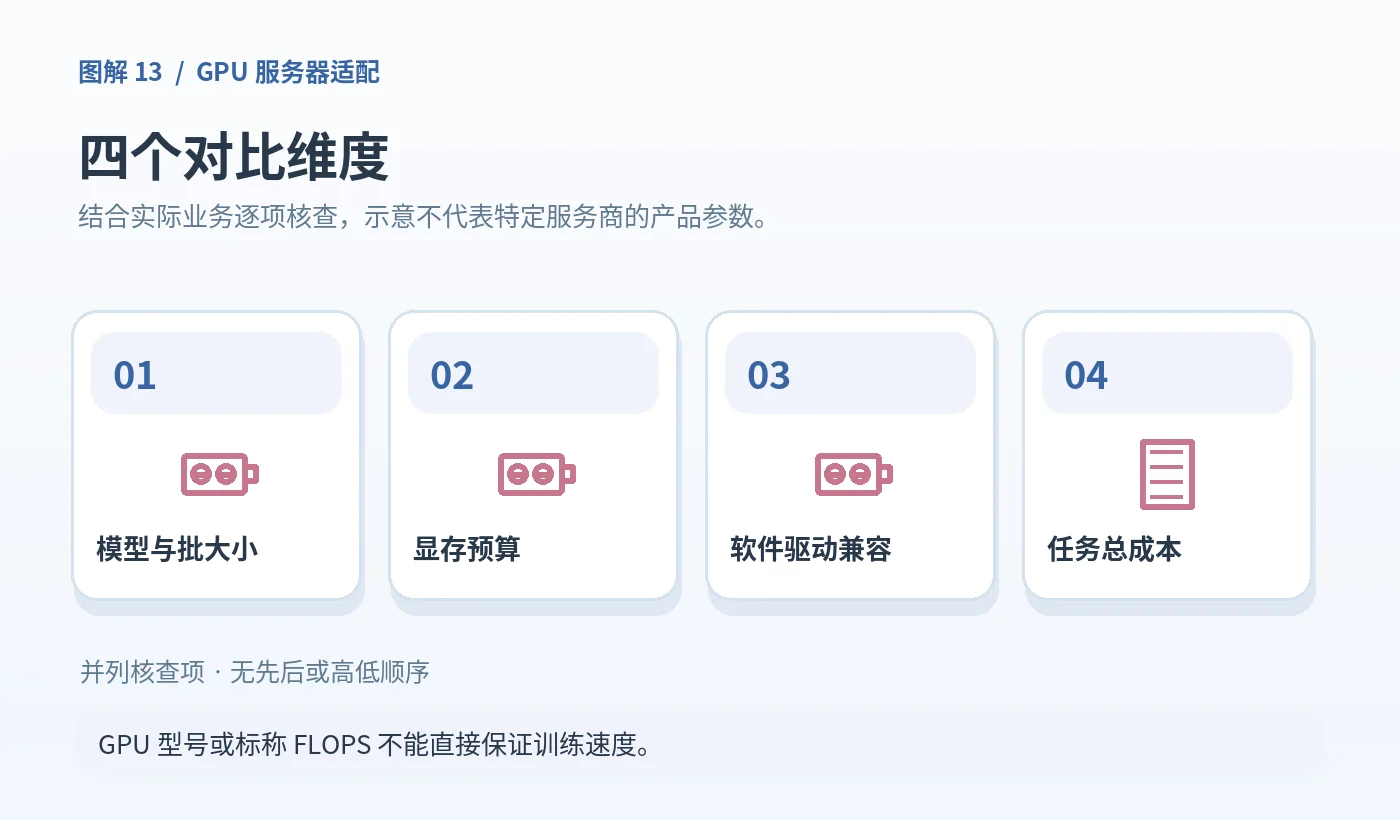
图示:GPU 服务器适配——整体结构或执行步骤(原创信息图,须结合实际条件核验)。
价格以总完成成本比较
小时费乘以有效运行时间,加上数据上传下载、磁盘、快照、闲置实例和可能的公网流量。对于间歇任务,计算启动/排队/拉取模型权重的附加时间;抢占式实例需要容错检查点机制。
采购验收模板
用自己的模型和代表数据记录冷启动、显存峰值、每秒样本或token吞吐、p95推理延迟与运行成本。只有在相同模型、精度和批量条件下,跨套餐对比才有意义。
用显存预算代替单纯比较“多少核”
同一模型的显存占用与参数规模、权重精度、KV缓存、批次长度和框架额外开销共同有关。可以先用模型实际加载后的峰值显存作为基线,并为运行时临时张量和峰值请求保留余量。单看模型权重文件大小往往会低估推理占用;多卡也不保证自动把模型平均分到每张GPU。
| 业务目标 | 优先测试 | 常见隐藏开销 |
|---|---|---|
| 单请求低延迟推理 | 首token延迟、p95输出延迟 | 冷启动与KV缓存 |
| 高并发批处理 | token/s或任务/s与显存峰值 | 请求排队与数据装载 |
| 模型微调 | 实际梯度/优化器内存与检查点 | 多卡通信、训练中断 |
计费不能只用实例时薪做结论:单任务成本 = 总计费金额 / 成功完成任务数量。测试时记录精度、批量、上下文长度、模型版本与启动成本,这样下次调价或换卡仍能复核。
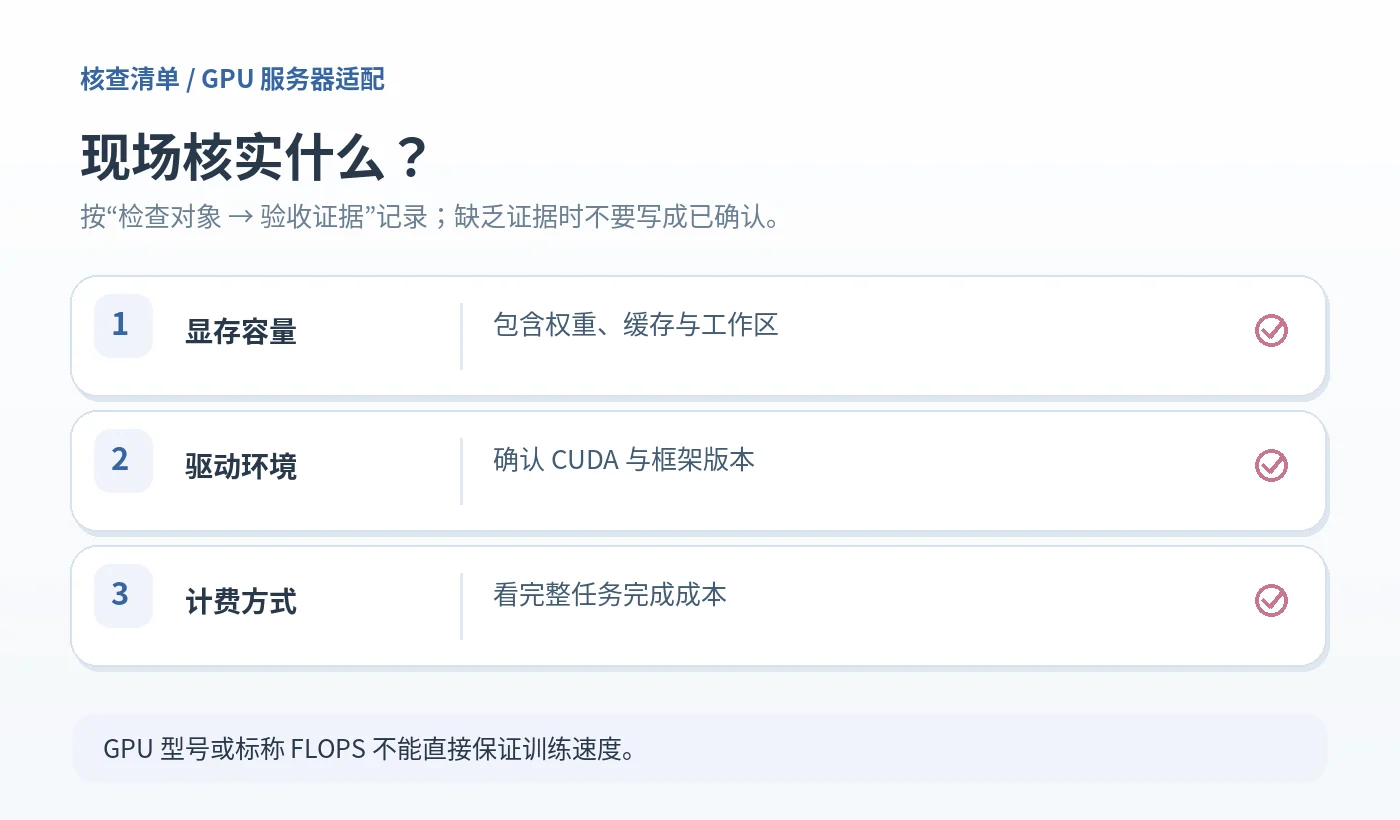
图示:GPU 服务器适配——采购核查与技术验收清单(原创信息图,须结合实际条件核验)。
上线或采购前的最终检查
- 运行真实模型样例并测显存峰值
- 确认驱动与计算框架版本
- 核算存储及出方向流量费用
- 比较完成单位任务的实际花费
注意:未经同等条件实测,不发布“训练快3倍”之类绝对比较。
进一步阅读
与当前问题相关的延伸内容:企业服务器配置怎么评估:CPU、内存、存储和可维护性。
官方资料与参考依据
- NVIDIA技术博客讨论模型大小、精度与GPU显存容量的关系。:NVIDIA技术博客讨论模型大小、精度与GPU显存容量的关系。
- NVIDIA CUDA最佳实践建议分析访存、并行度并用工具定位瓶颈。:NVIDIA CUDA最佳实践建议分析访存、并行度并用工具定位瓶颈。
🏗️ 架构合理
⚡ 简洁有力