
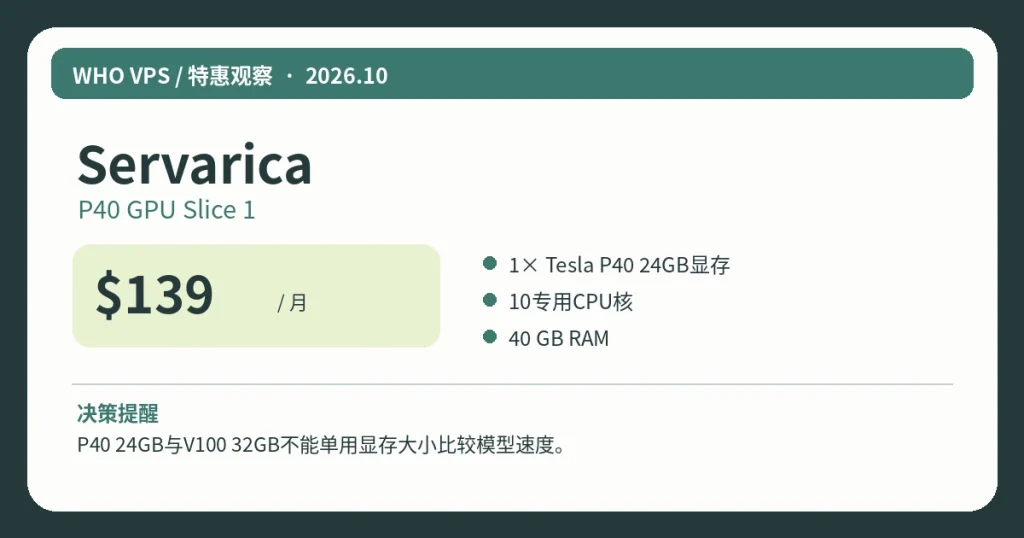
谈到Servarica的P40 GPU Slice 1,价格和产品类型必须同时看。这不是“免费体验AI的便宜VPS”,而是给明确需要显卡直通、私有模型推理的团队准备的GPU虚拟机。关键问题是24GB显存能否容纳目标模型以及系统内存和I/O是否匹配,不能只看GPU卡名。
商家官网入口:访问 servarica.com 官方网站。以下优惠信息取自文末所列公开资料,实际可购状态及结算金额须以商家当时页面为准。
价格背后的产品差异
官方P40页面列139美元/月、10核、40GB内存与500GB NVMe;活动帖还列V100 32GB显存版本179美元/月。商家公布的模型token速度属于其自行测试,测试机器及并发场景可能与实际负载不同。
套餐事实卡
| 项目 | 信息 |
|---|---|
| 服务商 | Servarica |
| 产品/套餐 | P40 GPU Slice 1 |
| 公开报价 | $139/月 |
| 地区 | 加拿大蒙特利尔 |
| 优惠状态 | 按论坛发布条件 |
| 主要指标1 | 1× Tesla P40 24GB显存 |
| 主要指标2 | 10专用CPU核 |
| 主要指标3 | 40 GB RAM |
| 主要指标4 | 500 GB NVMe |
GPU显存才是第一道预算关
选择GPU实例之前,应把模型权重、KV Cache、并发数及量化策略放在一张表上;24GB显存可能满足某些量化模型,但不能保证任何模型都能完整运行。开发与测试的闲置时间也应纳入月度成本。
V100价格更高,性能与显存容量也不完全等比例。先用实际模型的推理测试和量化方式评估吞吐,否则即使标称显存足够也可能不满足多人并发。
自托管模型不只有显卡月租
在下单页选择带宽策略,确认GPU是否实际直通和相关驱动。
- 显卡实际交付型号、显存与CUDA运行环境
- 模型权重大小、量化后显存和上下文长度
- CPU内存、磁盘容量与网络传输瓶颈
- 开通、暂停和计费规则,长期闲置成本
哪些人适合,以及哪些人应该换一种方案
适用需求:希望运行自托管推理、不便把材料送至外部API的研发团队。
不适用的需求:只需偶尔调用云API、不具备模型部署与驱动维护能力的个人。
价格、活动日期与真正要支付的钱
P40单卡$139/月;V100单卡$179/月,均为商家页面/原帖价格,不是优惠码折扣(查看商家活动原帖)
GPU独享是产品声明,但同宿主多租户压力下的内存带宽表现未被独立证实;也要确认网络月流量与端口模式。
还要注意的一个细节
同产品可选100TB/10Gbps或250Mbps不限流量等不同网络方案
读者常问
P40和V100选哪个?答:先按量化模型显存需求、推理速度要求和月度负载预算比较,不要只按显存GB数判断。
GPU套餐先从模型需求倒推
P40与V100不仅显存容量和算力不同,驱动、框架版本以及部署软件兼容性也需要先确认。购买139美元档之前,先明确模型需要的显存、支持的CUDA版本和网络出口模式,而不是只看GPU名字。
对CPU、内存和存储部分可参考虚拟机CPU、内存与磁盘选型,再结合本次套餐参数决定是否下单。
交流与讨论