
先监控,再优化,不要反过来
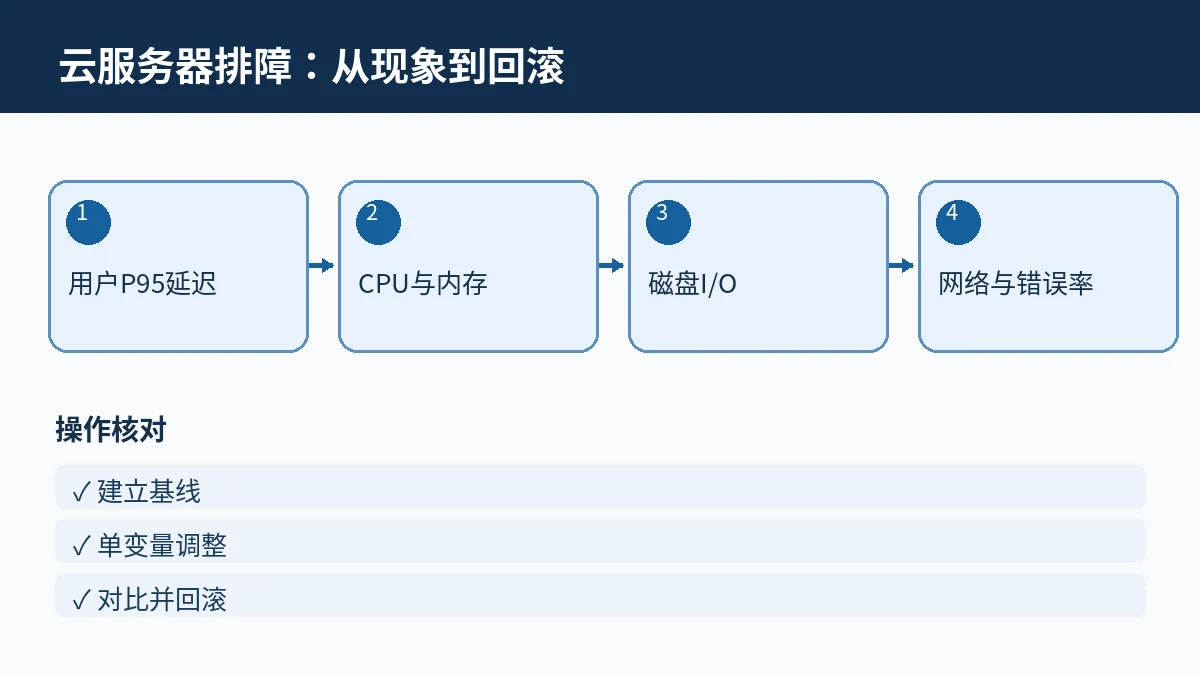
CPU 使用率、内存可用量、磁盘延迟、网络丢包与应用 95/99 分位响应时间分别反映不同问题。单独看到 CPU 达 90% 不必然意味着用户受影响;持续错误率与响应恶化更值得优先处理。
检查顺序与执行建议
建议建立基础基线:采集系统和应用指标,记录部署版本及报警阈值,按先复现后定位的方式分辨代码、数据库、磁盘还是网络瓶颈。每次仅调整一个参数,比较相同负载前后数据;保留配置快照,避免“优化”后难以回滚。
与主题相关的原有技术参数
技术规格或数值引用需依具体部署环境判断,以下是此前资料中的例子,不代表独立性能实测。
- 磁盘I/O :使用iostat工具追踪读写延迟,优化NVMe SSD性能。
- 自动扩展 :利用Kubernetes集群动态调整资源,参考 KVM与Docker整合指南 提升虚拟化效率。
实例级与应用级指标要结合
Prometheus/Grafana 或云平台自带监控能观察主机资源,但无法天然知道订单接口失败了多少次。建议同时记录 HTTP 5xx 比例、业务成功率、P95 响应、数据库连接池与系统 IO 等数据。一次配置变更必须有可追溯时间戳,方便通过日志判断优化是否有效。
在实际决策过程中,还可以结合 性能与成本的取舍 进一步对照相邻问题,避免只看单一参数。
下图将上述判断拆为可逐项核对的步骤,建议在修改生产环境前记录初始状态。


交流与讨论4 条评论
评论已关闭。