
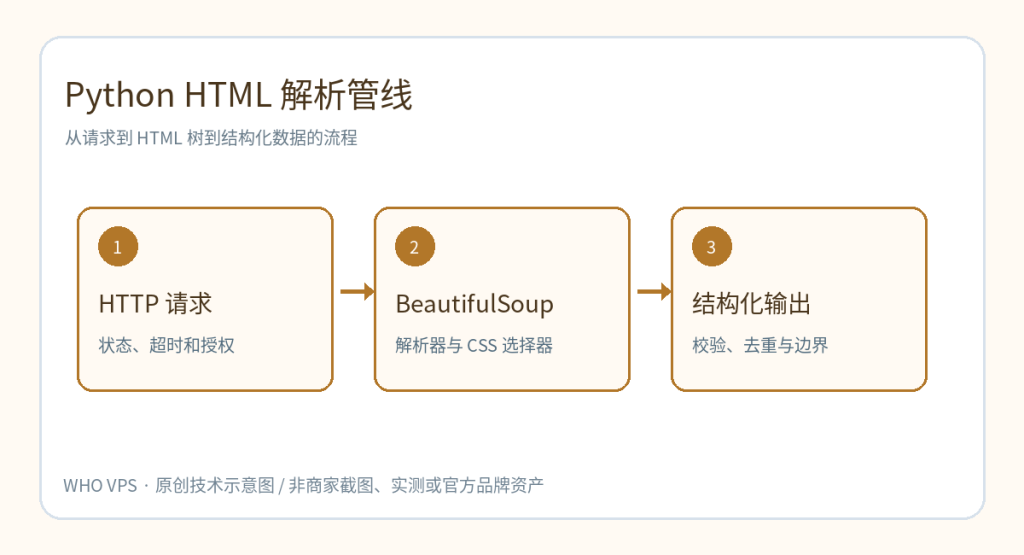
用 BeautifulSoup 解析静态 HTML
BeautifulSoup 适合将获取到的 HTML 文本转换为树状结构;lxml 是常用解析器之一。它不会自动执行 JavaScript:网页源码中没有目标数据时,应先查看接口或合法浏览器渲染路径,而不是不断修改 CSS 选择器。
import requests
from bs4 import BeautifulSoup

url = "https://example.org/"
response = requests.get(url, timeout=10)
response.raise_for_status()
soup = BeautifulSoup(response.text, "lxml")
for link in soup.select("a[href]"):
    print(link.get_text(" ", strip=True), link.get("href"))
解析失败如何排查
- 先检查响应状态、内容类型与响应长度;不要将错误页的 HTML 当目标数据。
- 在浏览器“查看网页源代码”确认数据是否在原始 HTML;仅在前端 DOM 出现的内容可能是异步加载。
- 对于动态页面,优先使用经授权的公开 API;确需浏览器自动化时遵循网站条款与限速策略。
- 元素选择器应优先使用语义和稳定属性,避免依赖易变的 CSS 类名顺序。
生产采集的安全性
设置超时与退避、尊重 robots 和访问条款,不收集无授权的个人数据。数据入库前检验字段类型、重复记录和时区;HTML 解析成功不代表采集结果真实或完整。
一份可复现的 Python 解析实例
from bs4 import BeautifulSoup
html = '<ul><li class="item">A</li><li class="item">B</li></ul>'
soup = BeautifulSoup(html, 'html.parser')
items = [node.get_text(strip=True)
         for node in soup.select('li.item')]
print(items) # ['A', 'B']| 解析器 | 前提 | 特点 |
|---|---|---|
| html.parser | Python 标准库 | 无额外解析器依赖 |
| lxml | 单独安装 lxml | 语法树修复规则可能不同 |
面对不完整 HTML,选不同解析器可能得到不同的 DOM。抓取第三方站点前检查使用条款、robots 策略、请求频率及个人信息处理规则;不要把一份示例脚本作为无限采集授权。
相关教程与进一步检查
若需要继续处理实际环境中的关联问题,可阅读Python max 函数;在线 Java IDE 选型可帮助补充不同的选型或验收视角。两者属于独立问题,按当前环境自行核对适用版本。

