
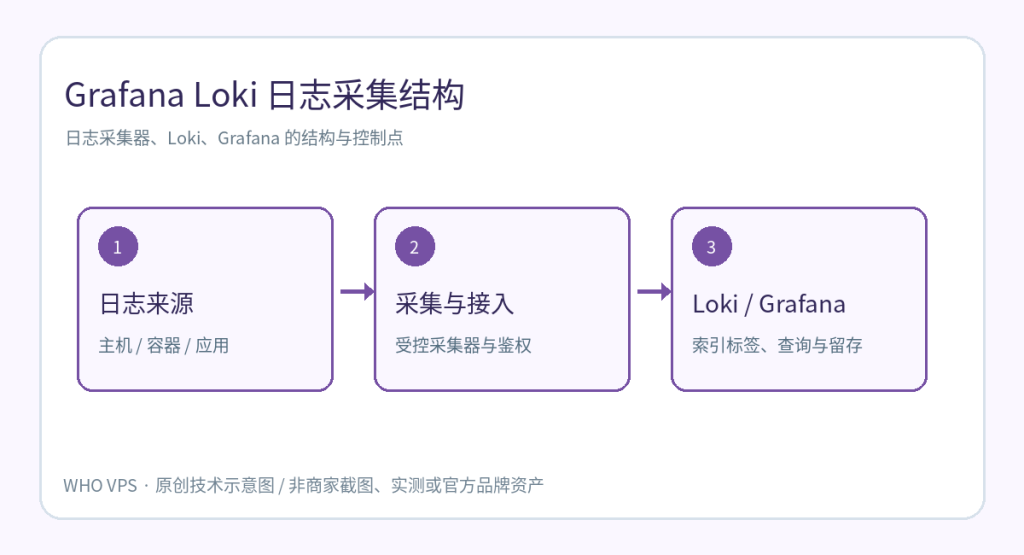
Loki 的基本链路
Grafana Loki 是按标签组织日志流的集中式日志系统。采集器读取主机或容器日志并转发到 Loki,Grafana 使用 LogQL 进行查询。选择标签时宜用服务名、环境或主机组等低基数字段,避免把用户 ID、随机请求 ID 作为标签导致流数量暴涨。
先做实验,再选择生产部署方式
可按 Grafana 官方的 Docker/Compose 教程在隔离环境完成单机实验:运行 Loki、配置受支持的采集器、向 Loki 写入测试日志,再在 Grafana 配置 Loki data source 并执行查询。生产环境还需根据规模选择 Helm/Tanka 等部署模式、外部对象存储、网络访问控制和备份。
三个不可遗漏的生产参数
- 访问控制:Loki 本身不自带完整认证层,不能直接把未经认证的写入与查询端口暴露到公网。
- 日志保留:使用 Compactor 配合 retention 配置;只改存储桶生命周期可能造成指标与日志内容错位。
- 查询成本:先按标签缩小范围,再过滤内容,观察最宽查询窗口与资源上限。
版本与迁移
采集器和配置字段应与部署当时的 Loki/Grafana 版本对应。后续工具生命周期发生变化时要另外核对升级路径,不能把后来才发生的弃用时间当成本文发表时已经发生的事实。正文中的配置应以实际部署环境的官方示例为准。
部署前先画出日志采集与留存路径
应用写入日志后,由适配的采集器读取并添加有限的标签,再发送到 Loki,Grafana 使用 LogQL 查询。不要把用户 ID、请求 UUID 等高基数值作为索引标签;这会增加流数与资源占用。对敏感日志先做脱敏和访问控制。
保留期应和使用的存储后端、Compactor 配置与 Loki 版本相符;不能仅在 YAML 写一个数字就假定磁盘已及时释放。验证时逐项检查采集失败、重试队列、租户隔离、查询限额与对象存储成本。旧教程可能使用 Promtail,制定 2026 年部署方案时要核对其生命周期及 Grafana Alloy 迁移路径,不能把后来的工具更替写成 2025 原发表日已有的状态。
相关教程与进一步检查
若需要继续处理实际环境中的关联问题,可阅读数据中心迁云计划;Java Web 请求处理可帮助补充不同的选型或验收视角。两者属于独立问题,按当前环境自行核对适用版本。
交流与讨论1 条评论
评论已关闭。