
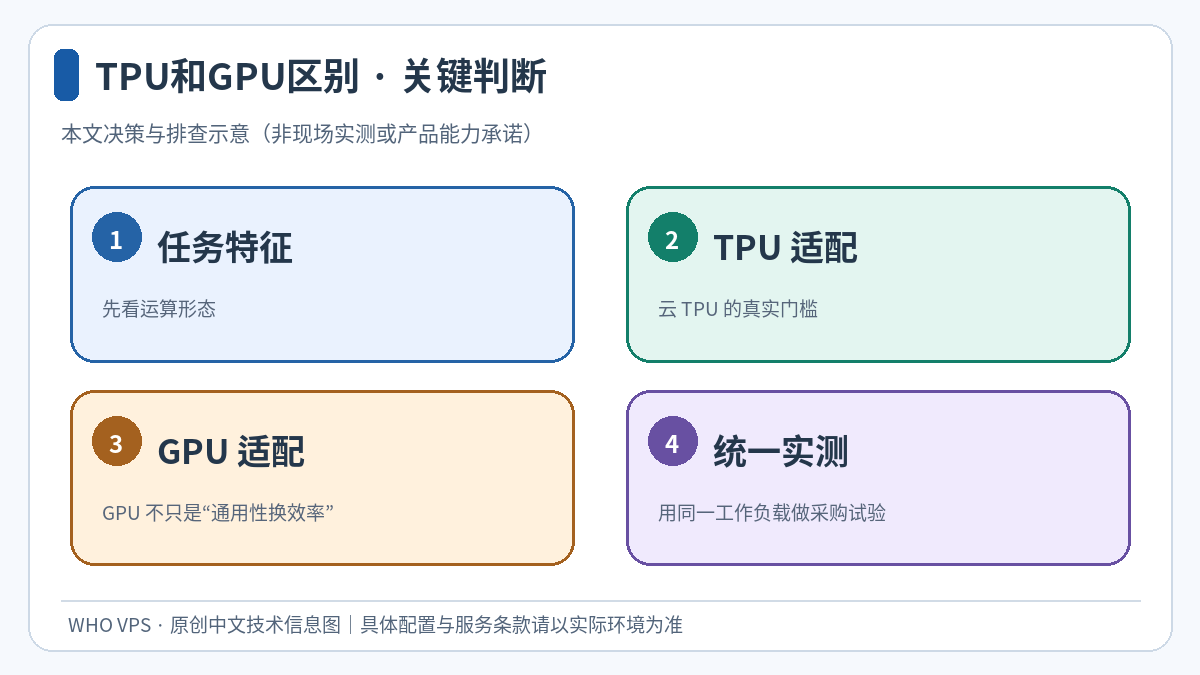
定制芯片是否比 GPU 更适合,取决于模型、算子、编译工具链和实际工作负载,而不是某款芯片的一条 TOPS 数字。TPU 属于专用加速器;GPU 具备广泛的并行编程生态。两类平台既竞争也互补,没有普适的“性能高三倍”结论。
先看运算形态
密集矩阵乘法、稳定的张量维度与较大批处理,往往有利于专门设计的矩阵加速单元;大量自定义算子、动态控制流程、图形任务或已有 CUDA 代码的项目,迁移 GPU 生态可能更省工程成本。还需分清训练与推理:推理重点常是请求延迟、并发和单位请求成本,训练更重视吞吐、通信与检查点保存。
云 TPU 的真实门槛
Google Cloud 文档说明,TPU 通过 XLA 编译适配模型图,部分动态形状与不受支持算子可能增加适配难度。租用前应在小规模样本上核对框架版本、算子覆盖、数据输入吞吐以及模型收敛表现。不能只按理论 FLOPS 比较,显存或 HBM 容量、互联、数据加载速度都可能成为瓶颈。
GPU 不只是“通用性换效率”
NVIDIA CUDA 提供成熟的并行模型和相关工具链,在深度学习、科学计算与自定义内核中使用广泛。GPU 实例的可得性、驱动依赖、框架兼容性与团队已有经验,会直接影响项目上线速度。GPU 的某些负载也有针对矩阵计算的硬件加速;因此“GPU 没有专门 AI 加速”并不成立。
用同一工作负载做采购试验
固定模型版本、精度、batch size、输入数据和目标指标,分别记录端到端训练时长、每秒处理量、P95 推理延迟、能耗相关资料及实际计费。把开发迁移、调试、模型转换、存储与跨区数据费用计入总成本。如果只有某一项目的账单与测试数据,不应据此声称所有任务都更便宜或更省电。
上线前的核对清单
- 先判断是训练、推理还是通用 HPC
- 检查框架和自定义算子兼容性
- 统一精度、batch 和数据源进行试验
- 同时计算算力费用与迁移工程成本
如果还需要延伸排查,可参考站内的数据中心 PUE 基础。
技术资料
关键概念以TPU 的架构、适用负载与 XLA 限制、CUDA/GPU 的并行计算模型与生态为依据;实际版本、价格与机房参数请另行核对。
嘿,2025年这波云端定制芯片要是真能扛起高性能计算的大旗,GPU的垄断地位可就悬了。别忘了,AI模型越做越大,算力需求像火箭一样蹿升——如果云服务商能把芯片按需“打印”出来,那才是真正的算力民主化。拭目以待!
当云端的星辰坠入硅基的河床,定制芯片是否真能以光速织就计算的锦缎?2025年,那抹未至的曙光,是否足以照亮GPU留下的深谷?
云端芯片如星辰落于数据之海,2025年或将织就一场算力的诗篇。它不单是技术的跃迁,更是智慧在无形中雕刻未来轮廓的轻吟。
亟需权威机构发布云端定制芯片性能评估标准,推动行业统一测试框架,以客观衡量其在高性能计算中替代GPU的潜力,确保技术发展透明可信。