
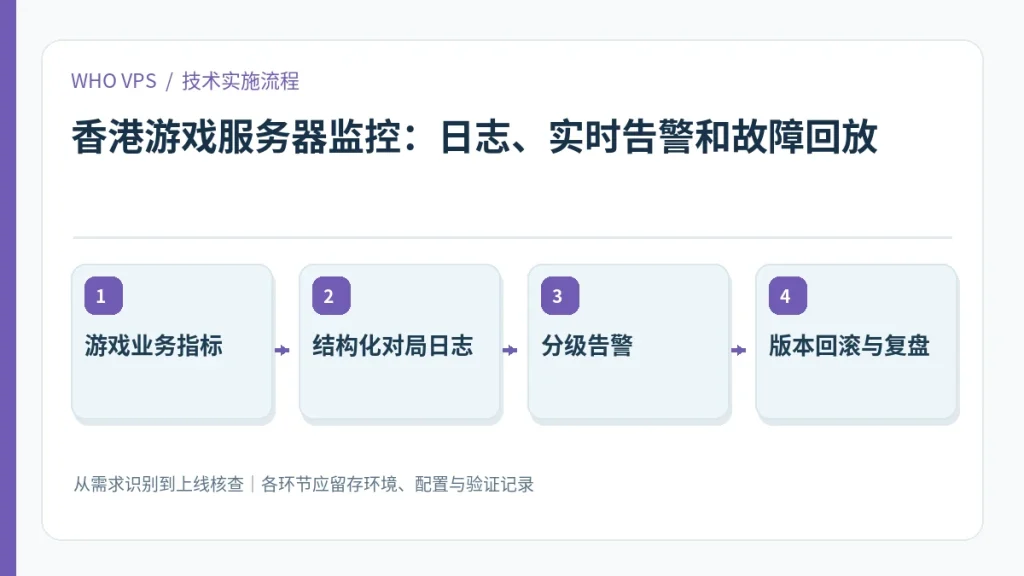
游戏服务故障排查最怕只有 CPU 曲线,没有玩家、房间或对局的上下文。香港游戏节点应将服务器指标、网络健康与业务事件关联,并控制日志中的玩家个人信息。
建立三层监控
基础设施层采集 CPU、内存、网络丢包与容器重启;游戏实例层跟踪 Tick 执行时间、在线会话、房间数和每局资源占用;业务层关注匹配成功率、登录错误与掉线重连。三层关联才能判断卡顿来自机房网络还是游戏逻辑。
结构化日志比堆大量文本更有效
为对局分配匿名追踪 ID,记录时间戳、节点、版本、错误码与关键状态变化。避免把明文访问令牌、玩家聊天记录和敏感身份信息写入长期日志。日志系统按保留期和索引基数控制成本,热点问题可临时提高采样率而不是永久全量记录。
告警必须能指导值班人员
把持续 Tick 超时、节点失联、重连失败率上升和数据库积压接到不同优先级的处理流程。每项告警包含当前版本、实例、可能影响的玩家数及回滚方案;发布新版本后特别关注异常率是否抬升。
实施前需要记录的三类证据
| 检查维度 | 应记录的内容 | 操作与验收方法 |
|---|---|---|
| 游戏内时序 | Tick 率、帧时间和后台队列 | 真实会话按负载层级回放 |
| 网络稳定 | RTT p50/p95、丢包、抖动 | 目标玩家地区进行持续采样 |
| 数据一致性 | 玩家状态、交易流水及重连 | 模拟断线和重试边界 |
游戏业务指标到版本回滚与复盘:工作流程图
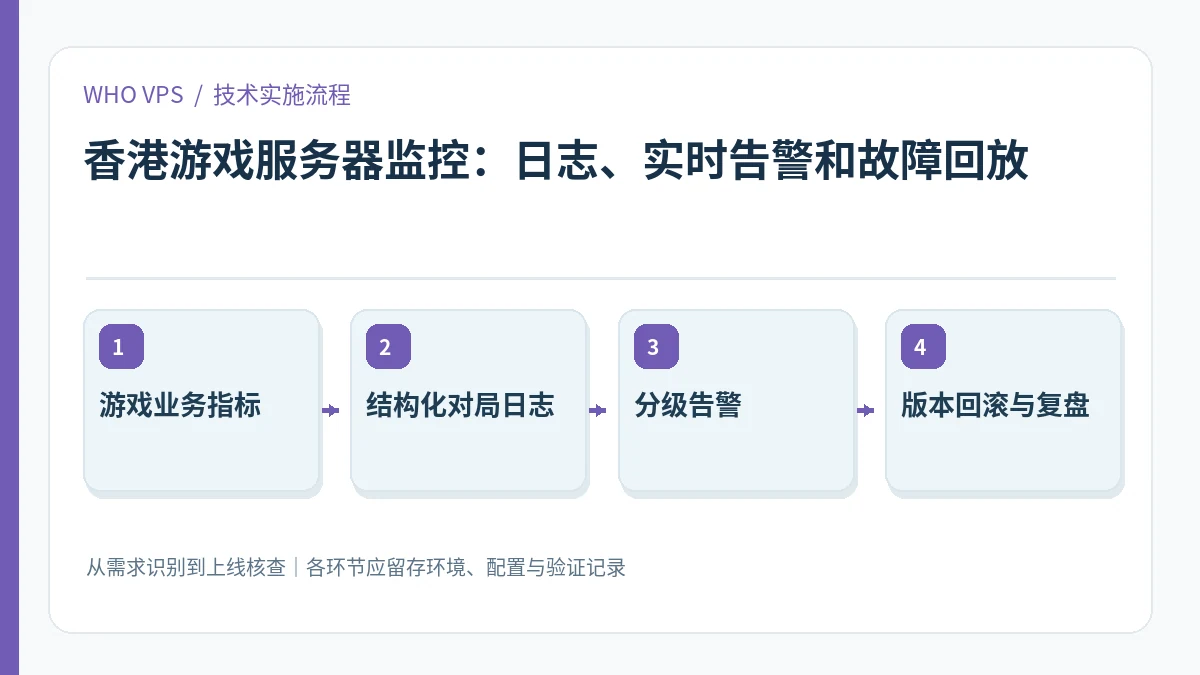
以下流程是落地执行顺序,建议为每一步保留配置快照、操作人和校验结果;在生产环境修改之前先准备恢复路径。
- 游戏业务指标:明确当前环境与业务目标,列出系统版本、权限、地域和预期负载。
- 结构化对局日志:根据上一阶段信息选择可回退的配置,避免同时修改多个相互影响的变量。
- 分级告警:以受控测试或对照环境验证配置,遇到异常优先查看日志和监控。
- 版本回滚与复盘:记录结果和剩余限制,把复测触发条件纳入日常巡检。
怎样判断方案有效,以及不适用的情况
验收依据:模拟断开测试实例、停止数据库连接和降低网络带宽,确认告警、日志时间线及故障后的自动恢复流程可用。
使用限制:不要把 Prometheus 抓取端点及带玩家信息的监控面板直接暴露到公网。
如果观察结果不稳定,先保持业务场景、测试位置与时间段可比,再判断是资源瓶颈、服务边界还是配置错误。缺少可复现的数据时,不应把单次结果外推成稳定收益。
官方资料与进一步阅读
- AWS:游戏服务指标、告警与容量管理:以产品/项目的现行官方说明为配置与版本核查依据。
- Prometheus:采集与查询基础:以产品/项目的现行官方说明为配置与版本核查依据。



哎哟,2025年香港游戏服务器还能靠“日志记录”续命?是不是该改名叫《如何用Log骗过玩家:从闪退到“系统维护”的艺术》?建议加个自动弹窗:“检测到您正在认真看日志——恭喜,您已获得‘资深运维体验官’称号!”