
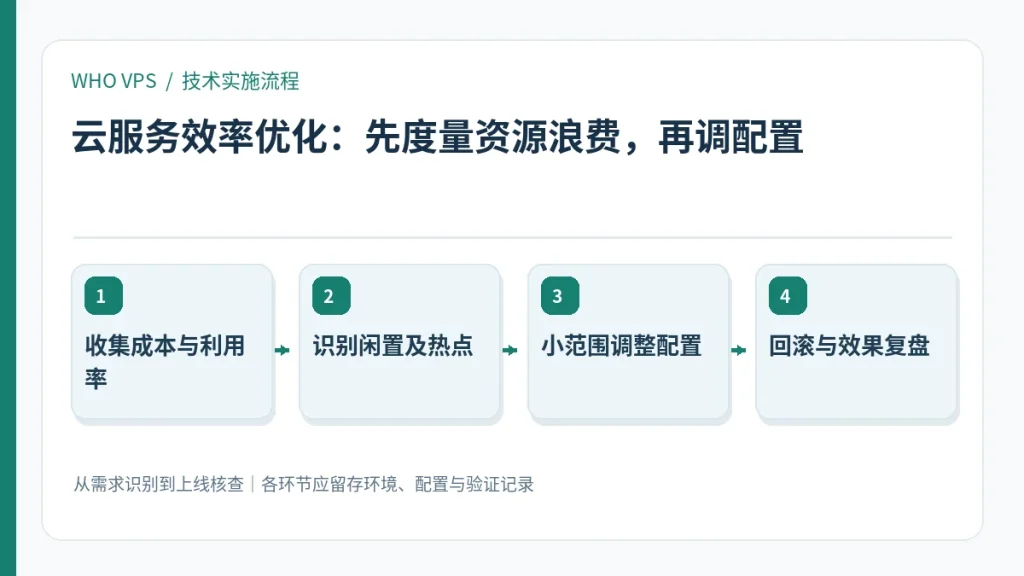
提升云服务效率不意味着一味缩小实例。真正有意义的优化要在性能目标和成本之间取得可验证的平衡,并保留对故障、增长和高峰流量的合理余量。
给每类资源找对应指标
计算实例看 CPU 使用分布与实际排队;存储看吞吐、IOPS、时延和容量增长;数据库看慢查询及连接池;网络看丢包、延迟与跨区出口费用。云平台自动推荐的机器规格只能作为候选,必须确认业务时段与观察窗口是否具有代表性。
先修低风险问题
清除不再使用的测试资源、孤立快照与重复日志;对真正闲置的定时任务做时间调度,再评估实例规格。需要低延迟的数据库不应仅因为平均 CPU 很低就直接降配,否则峰值突发可能带来更高延迟。
用预算和回滚保护优化
每次修改记录基线、预期节省成本、变更负责人和恢复方案。对于伸缩、缓存 TTL 或连接池的调整采用灰度发布;若错误率和 p95 延迟恶化,即便账单下降也应回滚。
实施前需要记录的三类证据
| 检查维度 | 应记录的内容 | 操作与验收方法 |
|---|---|---|
| 基础能力 | CPU、内存、SSD I/O 与公网流量 | 按实际业务曲线记录高峰和低谷 |
| 服务约束 | SLA、备份、迁出及工单覆盖 | 逐项读取套餐和服务条款 |
| 实际成本 | 实例、磁盘、带宽、快照和税费 | 按统一使用量比较全周期账单 |
收集成本与利用率到回滚与效果复盘:工作流程图
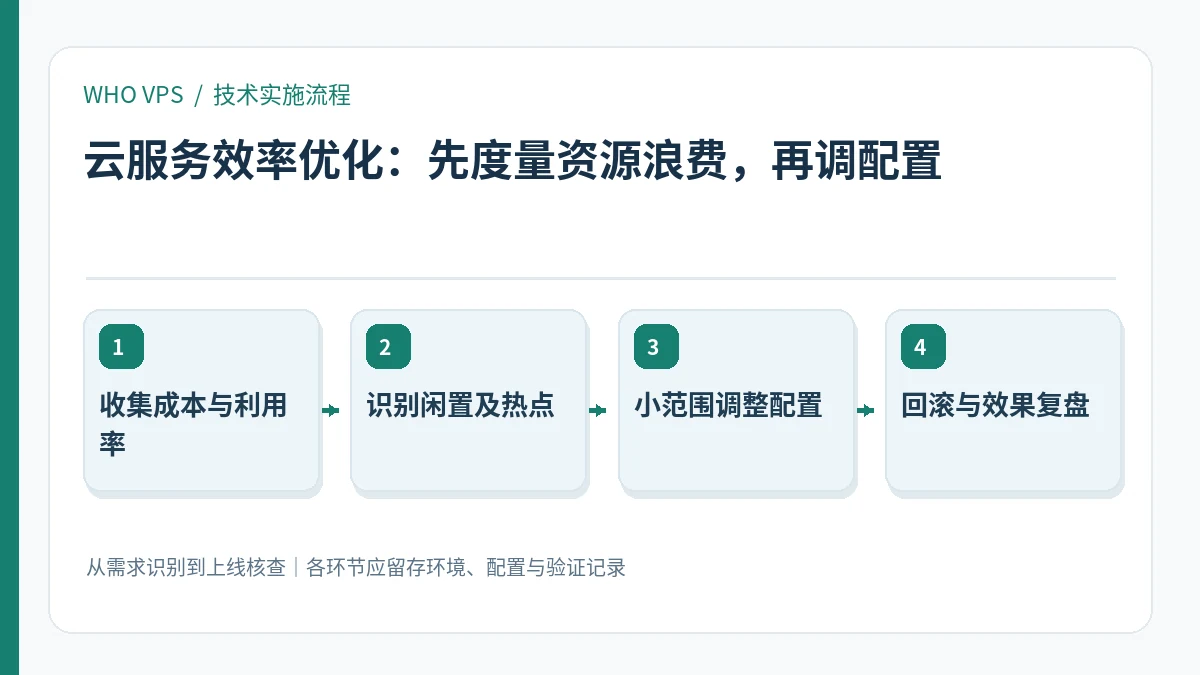
以下流程是落地执行顺序,建议为每一步保留配置快照、操作人和校验结果;在生产环境修改之前先准备恢复路径。
- 收集成本与利用率:明确当前环境与业务目标,列出系统版本、权限、地域和预期负载。
- 识别闲置及热点:根据上一阶段信息选择可回退的配置,避免同时修改多个相互影响的变量。
- 小范围调整配置:以受控测试或对照环境验证配置,遇到异常优先查看日志和监控。
- 回滚与效果复盘:记录结果和剩余限制,把复测触发条件纳入日常巡检。
怎样判断方案有效,以及不适用的情况
验收依据:记录每服务每月成本、CPU/内存利用率分位、错误率、p95 延迟与用户量,按同负载前后复盘。
使用限制:不能将云厂商文档的单机节省示例套用到未经测试的业务或承诺固定百分比降本。
如果观察结果不稳定,先保持业务场景、测试位置与时间段可比,再判断是资源瓶颈、服务边界还是配置错误。缺少可复现的数据时,不应把单次结果外推成稳定收益。
官方资料与进一步阅读
- 微软:迁移准备、评估与规划:以产品/项目的现行官方说明为配置与版本核查依据。
- Google Cloud:根据负载调整虚拟机实例类型:以产品/项目的现行官方说明为配置与版本核查依据。
延伸阅读:香港服务器内存优化:用 vmstat 定位交换与延迟问题;免费海外云服务器监控入门:Prometheus 与基础告警。


