
单靠脚本自动执行命令并不能称为可靠运维。配置管理、指标监控和告警响应属于不同环节:Ansible 擅长声明重复部署步骤,Prometheus 擅长采集时序指标;二者结合时,需要先定义目标资产、权限和变更回滚。
用 Ansible 保持环境一致
通过 inventory 描述主机分组,以 playbook 申明安装、配置、服务状态等任务。优先使用具有幂等性的模块,禁止在生产群组中无检查地执行危险 shell 命令。管理凭证需与代码仓库分离,先在测试环境 dry run,再限量发布。
Prometheus 负责观察而不是修复
部署合适的 exporter 收集 CPU、内存、磁盘、服务响应与应用指标,按业务定义标签和告警阈值。指标无业务上下文容易产生告警风暴;对用户影响最直接的错误率、延迟和可用性应该优先监测。
可在已经授权管理的环境中使用下面的只读检查命令作为排查起点;示例域名和 IP 不是实际生产目标:
ansible-inventory -i inventory.ini --list
# 先检查主机清单,再针对受控环境执行 playbook
形成变更与事故闭环
每次发布都记录变更版本、执行结果、回滚方法和负责人;告警要对应可执行 SOP,严重问题分级通知。运维效率应通过重复操作耗时、配置漂移、恢复时长和误告警率评估,而非单看工具安装数量。
如果需要进一步理解相关的配置或选型区别,可结合本站海外VPS故障排查参考,把技术目标、费用与故障处理放在同一份检查清单中。
可直接执行的核查步骤
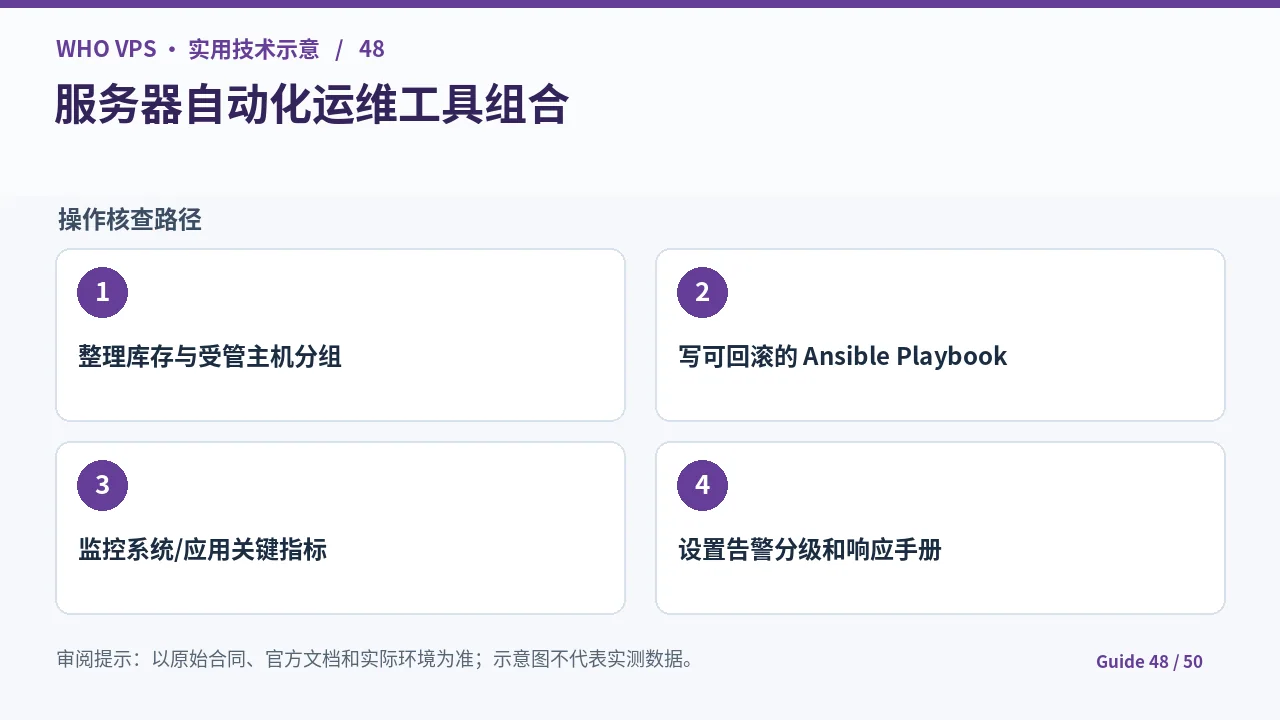
- 整理库存与受管主机分组
- 写可回滚的 Ansible Playbook
- 监控系统/应用关键指标
- 设置告警分级和响应手册
常见异常与处理对照
| 现象 | 优先检查 | 处理建议 |
|---|---|---|
| 自动化后配置反复变化 | playbook 不幂等或人工改动 | 使用模块并检查漂移 |
| 监控数据有但事故没发现 | 缺少用户可感知指标 | 补充 SLO 和黑盒探测 |
| 告警太多无人响应 | 阈值失真或缺少分级 | 按业务优先级收敛告警 |
常见问题
自动化后配置反复变化应该怎么办?
先识别playbook 不幂等或人工改动,再按“使用模块并检查漂移”核查。应优先完成“写可回滚的 Ansible Playbook”,保存相关配置和复测结果;不要跳过必要的权限和数据备份检查。
监控数据有但事故没发现应该怎么办?
先识别缺少用户可感知指标,再按“补充 SLO 和黑盒探测”核查。应优先完成“写可回滚的 Ansible Playbook”,保存相关配置和复测结果;不要跳过必要的权限和数据备份检查。
注意事项:自动化操作需要有界权限、审批、审计和备份;不要把 SSH 私钥、API Token 写进 Playbook 或图表面板。
参考资料与进一步阅读
- Playbooks 在 inventory 上声明自动化任务(来源:docs.ansible.com)
- Prometheus 用于指标采集、查询与告警体系(来源:prometheus.io)



那年我还在为半夜突发的服务器崩溃焦头烂额,直到遇见文章里推荐的自动化监控工具。从手动巡检到智能预警,运维效率翻了三倍。现在凌晨三点的咖啡,终于能换成安稳的睡眠了。
呵,又一个“神器”?建议改名叫《如何用20个花里胡哨的工具把简单问题复杂化》。运维不是靠堆工具炫技,而是解决问题。这篇文简直是给焦虑的工程师发了一张“买买买”购物券,顺便骗点广告费。