
高密度 IDC 的核心用途,是在有限机柜面积内稳定承载高 IT 功率的计算和存储设备。 它不等于“机柜塞满服务器”,也不等于“所有 GPU 机柜都必须液冷”。能否租用,取决于连续交付功率、单路故障下的冗余能力、实际散热和维护空间、东西向网络以及设备重量。
本文把机柜选型拆成一个能复算的 40kW 级假设项目,帮助采购者判断营销页上的“30kW / 50kW / 高密度”是否有实质含义。它不是针对任何单一 IDC 的测评或报价。
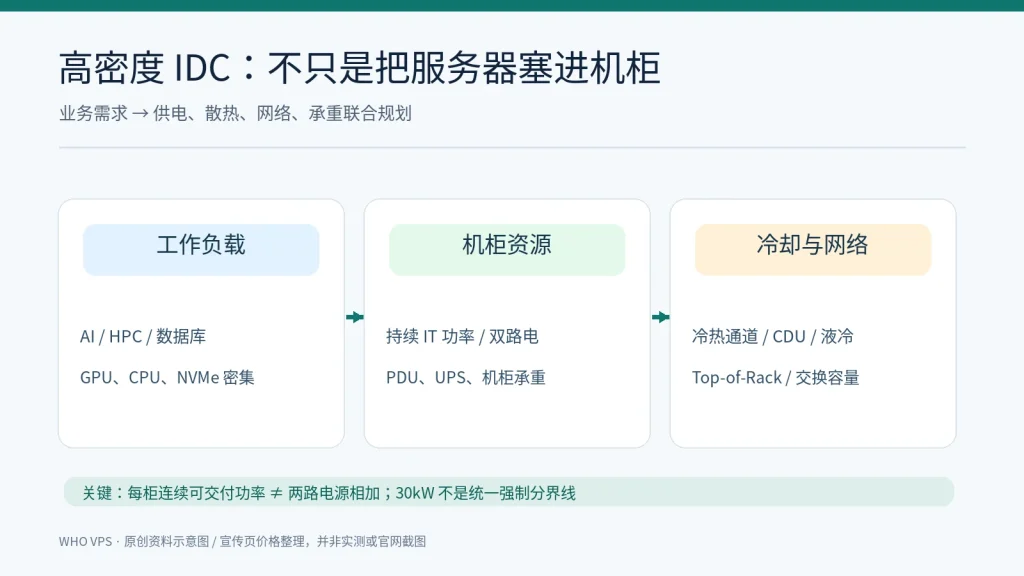
1. 哪些业务真的需要高密度机柜?
| 工作负载 | 提高单柜密度的原因 | 不能只看 kW 的附加要求 |
|---|---|---|
| GPU 训练 / 高吞吐推理 | 加速卡与高速互联密集,服务器功率高 | 热设计、GPU 间带宽、RoCE/InfiniBand、可维护空间 |
| HPC 科研集群 | 节点之间频繁交换数据 | 低时延网络、网络 oversubscription、同步计算的尾延时 |
| 视频转码 / 渲染 | GPU/CPU 密集且设备需要集中管理 | 设备功率曲线、散热随负载波动、网络出口 |
| 虚拟化与数据库 | 计算、内存和 NVMe 集中 | 内存/磁盘一致性、故障域、备份和维护迁移容量 |
| 高密度存储与归档 | 多盘位设备和大型机箱节约楼面 | 盘温与振动、盘阵电力、重型机柜/运输通道 |
Uptime Institute 在2026 年全球数据中心调查中指出,达到 30kW 及以上峰值机柜密度的运营商正在增多。但这不是任何通行的法律门槛,也不是意味着普通 Web VPS 必须采用 30kW 机柜。租机柜是否划算,要看自己的部署电力与用地效率。
2. 40kW 级 GPU 机柜怎样测算?
下面全部是教学假设,不是某款 GPU 服务器的真实功率,也不是任何托管商提供的套餐:
- 8 台计算服务器,每台在项目规划满载工况下 4.8kW,合计
8 × 4.8 = 38.4kW。 - 机柜两台 ToR 交换机及网络配套合计 1.2kW。
- 带外管理、配套控制器和可归入机柜的其他 IT 设备合计 0.6kW。
- 总连续 IT 设计负载:38.4 + 1.2 + 0.6 = 40.2kW。
如果采购方希望保留 20% 工程余量,需求为 40.2 × 1.2 = 48.24kW 的设计容量。这是为规划设置的假设余量,并非行业统一强制值;真正合同要写明“连续可用 IT 负载、冗余模式和允许的尖峰”。额定铭牌功率可能高于典型负载;应该以实际测得的峰值、同时率以及未来设备升级为依据复核。
热量估算可用 1 kW ≈ 3412 BTU/h:
| 计算量 | 示意值 | 怎样用 |
|---|---|---|
| 规划 IT 负载 | 40.2kW | IT 侧连续设备热耗散的基准 |
| 等效散热量 | 约 137,200 BTU/h | 40.2 × 3412,不等于设施实际制冷机选型 |
| 含 20% 工程余量 | 48.24kW | 规划与扩展的假设容限 |
| 设备数量 | 8 台计算节点 | 必须检查机柜 U 位、深度和维护空间 |
不要把 48.24kW 的电容量、137,200 BTU/h 的设备热量以及 PUE 乘法反复叠加。 PUE 衡量全设施能源投入与 IT 能耗之比,不是直接给每柜“热量乘一个 1.2”就能得到的局部冷却认证。PDU、CDU 泵、外置配电等具体热负载在哪里产生,应由 IDC 与设备厂家逐项划定边界。
3. 最危险的误区:A/B 双路电源不等于功率可以相加
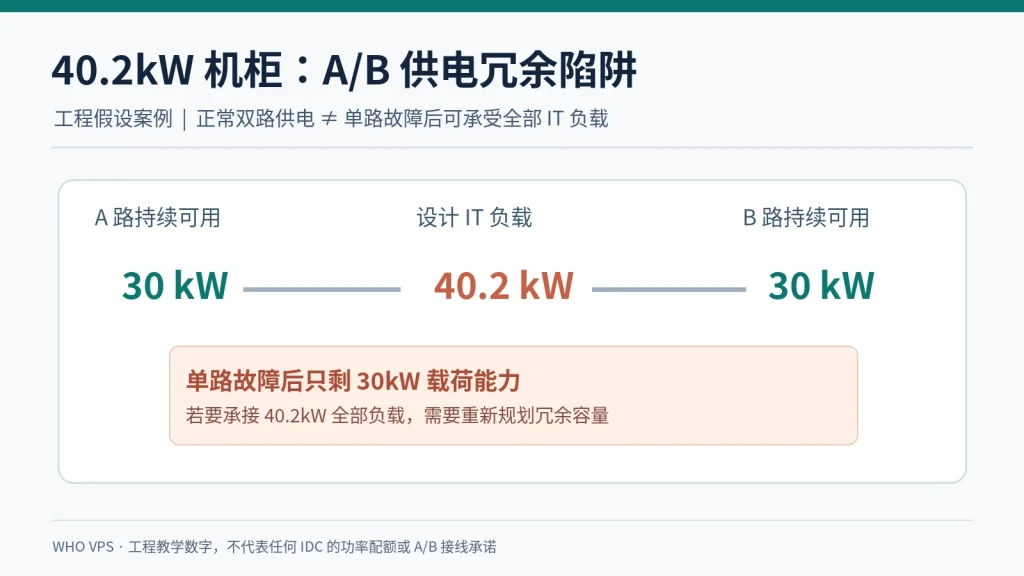
假设某高密度柜宣传有 两路 A/B,每路连续可承载 30kW。正常情况下看到两个接口就说“总共 60kW,所以这柜可安全运行 40kW”,这个结论可能是错的。
- 如果设计目标是一条失效、另一条完全接管(2N 类冗余),那么单一路可承载的最大负载才是约束:30kW 并不能在故障后承载 40.2kW。
- 如果是 N+1 或负载分摊,应让机房提供供电系统和 PDU 单点故障后的最大允许负载/保护设置,不可凭“两根电线”推定 2N。
- UPS、开关、配电支路、PDU 和每个服务器 PSU 都有自己的连续额定值及保护曲线。即使总合同写 50kW,也可能出现单支路容量不足或某相不平衡。
- 供应商若说“40kW 可用但不含冗余”,就要明确写入 SLA、业务风险和退路;不能营销成“40kW 双路冗余”。
采购时至少要得到:单路故障后的可用功率数值、端口与断路器图、正常及故障工况下 PDU 负载率、是否允许热插拔维护、客户设备上电浪涌限制。
4. 风冷、后门换热器、直冷液冷怎么选?
高密度并不自动等于必须液冷;应以服务器制造商许可的冷却方式、冷却水条件、风量、封闭通道能力和维护成本来决定。
| 冷却方式 | 更常见的适用情形 | 主要限制 |
|---|---|---|
| 优化风冷 + 冷/热通道封闭 | 中等密度、空冷服务器占多数 | 风量、冷热气流短路、局部热点、噪声 |
| 后门换热器 RDHx | 希望保留空气冷却的服务器而提高柜位热负载 | 水路、换热效率、门体与过道空间、泄漏检测 |
| 直接芯片液冷 D2C | 计算芯片热密度高、设备支持液冷 | 服务器冷板、CDU、供回水、快接头、维护授权 |
| 浸没式冷却 | 特定定制硬件与整体设施方案 | 设备适配、维护、材料兼容、供应链与场地交付 |
要求供应商回答四个具体问题:液体供应温度是多少?中断后能承受多长时间?冷却系统故障是否与电源故障同故障域?漏液检测和赔付责任如何写? 如果高密度柜不允许用户设备支持的散热方式,单看“柜租便宜”没有意义。
5. 网络和机柜空间才是 GPU 集群经常忽略的瓶颈
对训练作业,互联网出口与集群东西向网络不是同一物。数据中心宣传“1Gbps 国际带宽”不回答 8 台计算节点是否具备所需的高速互联、ToR 上联、PFC/ECN(如使用 RoCE)和网络隔离。
一套可交付的网络询价应有:每台计算节点网卡数量/速率;ToR 端口利用;Spine 上联带宽;网络超卖比;VLAN/VRF;多路径 ECMP;交换机电力与散热;跨机柜光纤/线缆与光模块;独立管理网;互联网出口带宽及计费。对于训练敏感业务,具体带宽门槛应以模型、训练方式、网络协议和实测来定,不要虚构“每台必须 400G”等一刀切指标。
承重与尺寸同样不可省:GPU 服务器可能很深且很重。需要检查机柜深度、RU 数量、滑轨兼容、楼板集中荷载、过道搬运路径、CDU/管线和前后维护空间。服务器装得下,不代表在运行状态下可以安全维护。
6. 高密度柜值不值得:用总成本而不是每柜月租比较
比较两个托管方案时,需要拿到下面这些成本:
| 成本项目 | 普通机柜拆分部署 | 高密度机柜集中部署 |
|---|---|---|
| 机位租金 | 通常多个机柜 | 柜数可能更少,但每柜功率价格可能更高 |
| 电力与超额计费 | 按每柜功率/用电 | 更高负载和冗余电力可能加价 |
| 冷却与液冷配套 | 传统设施内常含基本空冷 | RDHx / CDU / 冷板水路可能单独计费 |
| 网络交换与光纤 | 跨柜缆线与端口可能更多 | 柜内流量集中,但 ToR 与上联要求更高 |
| 人员操作与备件 | 分散设备更方便检修时也可能占地多 | 高密度维护更复杂,可能需特别 Remote Hands |
| 扩展与容灾 | 更容易按柜拆分故障域 | 单柜集中故障可能同时影响更多节点 |
不以 PUE 一项做采购决定。 对于只有少量中功率独服的公司,两个普通机柜可能比一个需要改造液冷的高密度机柜划算;对于已经有高功耗 GPU 集群且机柜数受限的项目,集中部署才可能节省机位和布线总成本。
7. 现场验收的十项硬条件
- 机房给出每柜连续 IT 功率,注明 N+1、2N 或无冗余,不用名义功率宣传代替。
- 单路失效模拟或设备设计证明确认另一路可承载多少 kW。
- PDU、UPS、配电分支容量、相位平衡、峰值与开机浪涌均有记录。
- 柜前进风温度、柜后出风温度、芯片温度边界和冷却报警可查看。
- 液冷项目写明供回水范围、流量、CDU 归属、泄漏停机方案和责任。
- 实际机柜、滑轨、维护门和楼板承重满足全部安装设备。
- 光纤路由、ToR/Spine 速率、交换机冗余和跨柜连接可验。
- 支持现场/远程运维的 SLA、备件存放、维护窗口与费用有明文。
- 电费、制冷、网络、上架、交叉连接和解约费用在同一份报价表中。
- 按双方认可的带负载测试和故障演练出书面验收记录;不能仅发一张机房宣传图。
8. FAQ
“高密度 IDC”是不是专指 AI? 不是。GPU、HPC、转码、内存密集型数据库和高密度存储都会推动密度上升。
30kW 能跑 8 台 GPU 服务器吗? 仅凭“8 台”无法判断,需按实际机器功耗、网络设备、启动峰值与故障工况加总。本文 8 台的假设就超过 40kW。
高密度机柜一定比普通柜省钱吗? 只有计入电、冷却、网络、部署与故障风险的总成本后才能确定。
资料来源与进一步核验:Uptime Institute 2026 调查发布 · Uptime 2026 调查简介。功率/热量实例为基础物理换算,并非引用供应商实测或行业强制阈值。


交流与讨论