
GPU 服务器究竟加速什么
神经网络训练的大量矩阵乘法和张量运算适合 GPU 并行处理;CPU 仍承担数据加载、调度和部分前处理。选择 GPU 不能只看 CUDA 核心数,应先核对所用框架、显存容量、精度支持、驱动与 CUDA 版本兼容性。
显存、算力和数据链路
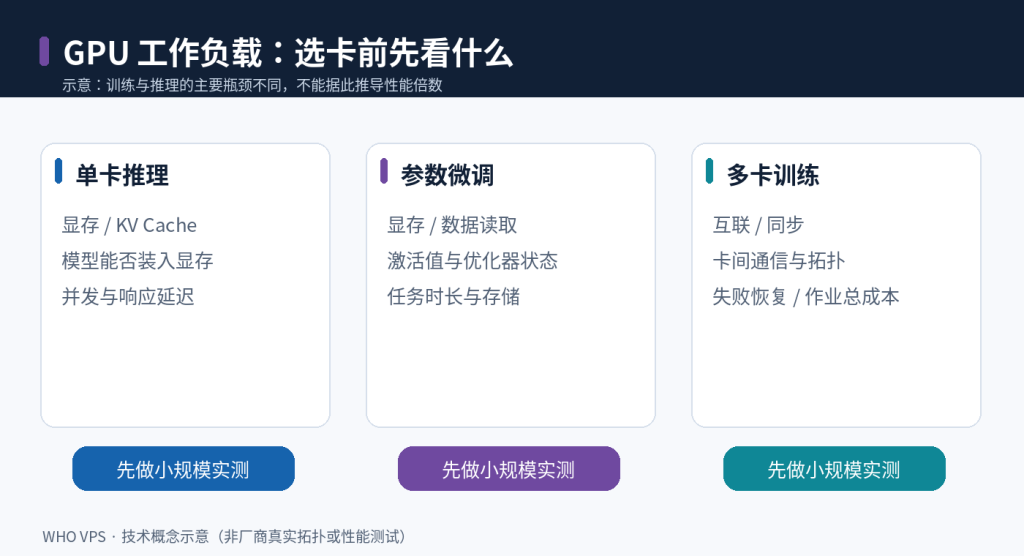
- 显存:模型参数、激活、优化器状态及 batch size 会共同决定峰值占用,OOM 时可先检查混合精度、梯度累积、检查点等措施是否适用。
- 互联:单卡小模型与多卡分布式训练的瓶颈不同;多机同步需要考虑 GPU 互联、PCIe 和网络集体通信开销。
- 存储:数据集读取、随机增强与缓存策略可能让 GPU 因输入等待而闲置。
采购前小规模验证
用实际模型、固定数据集、相同训练轮次、相同 batch size 与精度配置,记录每秒样本数、GPU 显存峰值、总训练时间和可恢复性。勿用商家宣传的通用 TFLOPS 直接预测自家模型性能。租用设备还应算入带宽、存储、镜像与空闲费用。
训练前用容量预算排除不合适的 GPU
模型训练的显存负担除权重外,还包括梯度、优化器状态、激活值、批处理缓存与通信工作区;推理与全量训练不能直接用同一个显存估算。精度、微批大小、序列长度和是否做激活检查点都会改变需求。
| 使用场景 | 优先核查 | 容易忽视的费用 |
|---|---|---|
| 单卡推理 | 显存可容纳模型与 KV cache | 空闲计费、出口流量 |
| 微调 / LoRA | 实际峰值显存、数据读取 | 数据盘和快照 |
| 多卡训练 | 卡间互联与同步开销 | 节点间网络、检查点 |
先在小规模任务上记录 OOM、吞吐、训练时长和单次作业总成本,才有依据比较不同 GPU;不要使用商家宣传的 FP16/FP8 算力数字代替实际作业性能。
相关教程与进一步检查
若需要继续处理实际环境中的关联问题,可阅读2U 四节点机箱核验;在线 Java IDE 选型可帮助补充不同的选型或验收视角。两者属于独立问题,按当前环境自行核对适用版本。
交流与讨论2 条评论
评论已关闭。