
GPU 型号只是起点。香港 GPU 服务器是否适合在线推理,取决于模型显存占用、并发队列、批处理策略和真实用户到机房的网络质量,而不是“GPU 越强、用户延迟必然越低”。
从模型约束反推配置
先确认模型权重大小、精度、KV Cache 和峰值上下文长度,再考虑显存冗余及 CPU 内存。多 GPU 不能简单将每张卡显存视为完全共享池;张量并行、模型并行也会引入跨卡通信成本。应确认具体服务器的 GPU 型号、驱动、CUDA 与推理框架版本。
吞吐与首字延迟要分别优化
动态 batching 可能增加吞吐,却也可能延长低负载请求的排队等待。对聊天类推理可记录首 token 时间(TTFT)和每秒生成 token 数;对批量图像任务则重点看单位时间处理量和失败重试。INT8/FP8 等低精度配置须在目标模型上验证质量,不可假定无损。
香港部署的网络与安全边界
从真实客户地区分别测试 TLS 建连、上行上传、下行 streaming 和跨区域网络波动。推理 API 要限制令牌权限与并发,记录任务用量而不是长期保存敏感原始提示。对于数据有地域要求的客户,还要核实处理与日志存储区域。
实施前需要记录的三类证据
| 检查维度 | 应记录的内容 | 操作与验收方法 |
|---|---|---|
| 模型瓶颈 | 权重/激活显存、模型精度和批量大小 | 对照同模型同输入测显存 |
| 服务体验 | 首 Token 时间、吞吐、p95 | 模拟真实并发而非裸算力 |
| 付费利用率 | 空闲占比、显存碎片、数据传输费用 | 记录使用与停机窗口 |
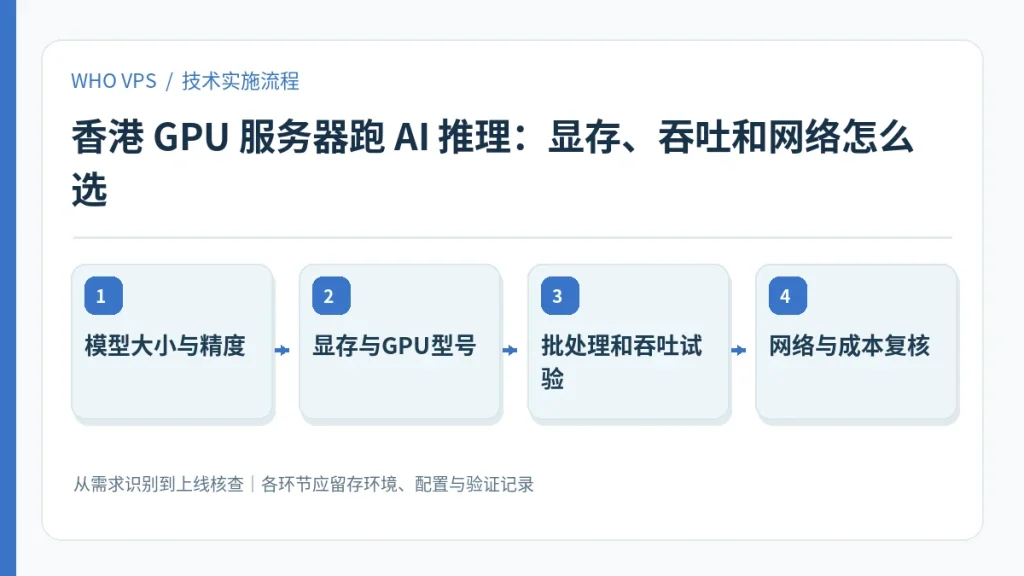
模型大小与精度到网络与成本复核:工作流程图
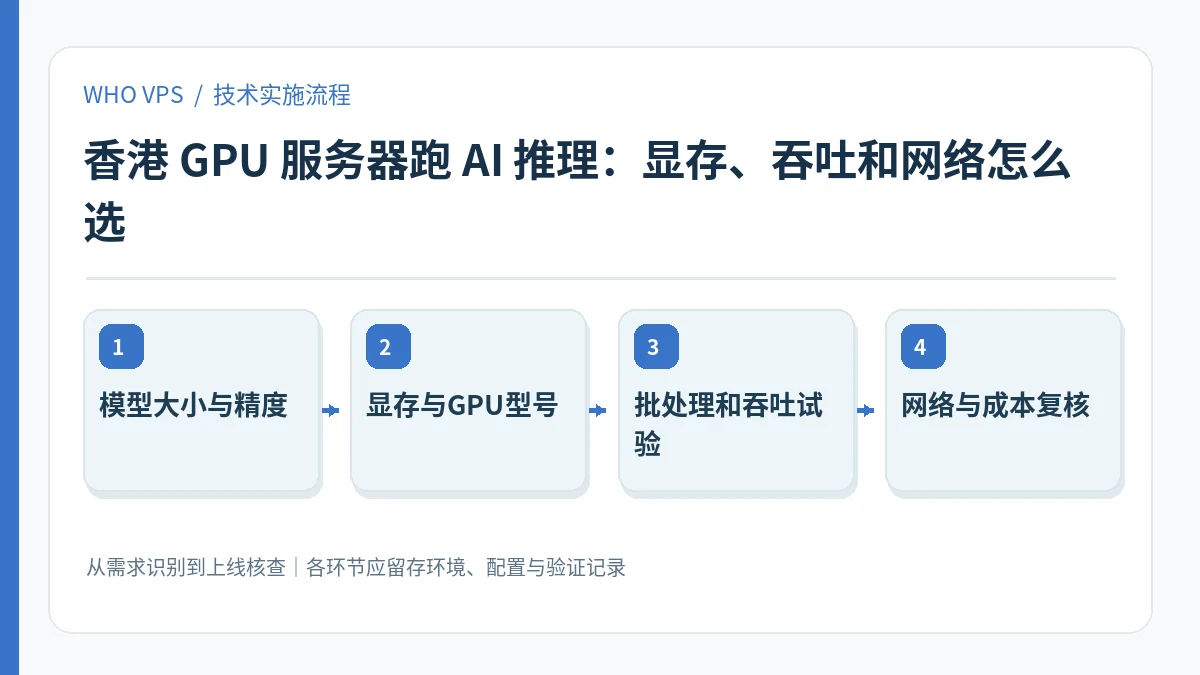
以下流程是落地执行顺序,建议为每一步保留配置快照、操作人和校验结果;在生产环境修改之前先准备恢复路径。
- 模型大小与精度:明确当前环境与业务目标,列出系统版本、权限、地域和预期负载。
- 显存与GPU型号:根据上一阶段信息选择可回退的配置,避免同时修改多个相互影响的变量。
- 批处理和吞吐试验:以受控测试或对照环境验证配置,遇到异常优先查看日志和监控。
- 网络与成本复核:记录结果和剩余限制,把复测触发条件纳入日常巡检。
怎样判断方案有效,以及不适用的情况
验收依据:在固定模型、请求长度与并发下比较 TTFT、p95 端到端延迟、显存峰值、每 token 成本,并记录批处理大小。
使用限制:未经厂商配置证明,不可宣称某香港节点必然提供 A100/H100 或特定 NVLink 拓扑。
如果观察结果不稳定,先保持业务场景、测试位置与时间段可比,再判断是资源瓶颈、服务边界还是配置错误。缺少可复现的数据时,不应把单次结果外推成稳定收益。
官方资料与进一步阅读
- NVIDIA:推理引擎性能优化与配置:以产品/项目的现行官方说明为配置与版本核查依据。
- NVIDIA:量化计算与精度权衡:以产品/项目的现行官方说明为配置与版本核查依据。



🔄 持续关注